官网预览
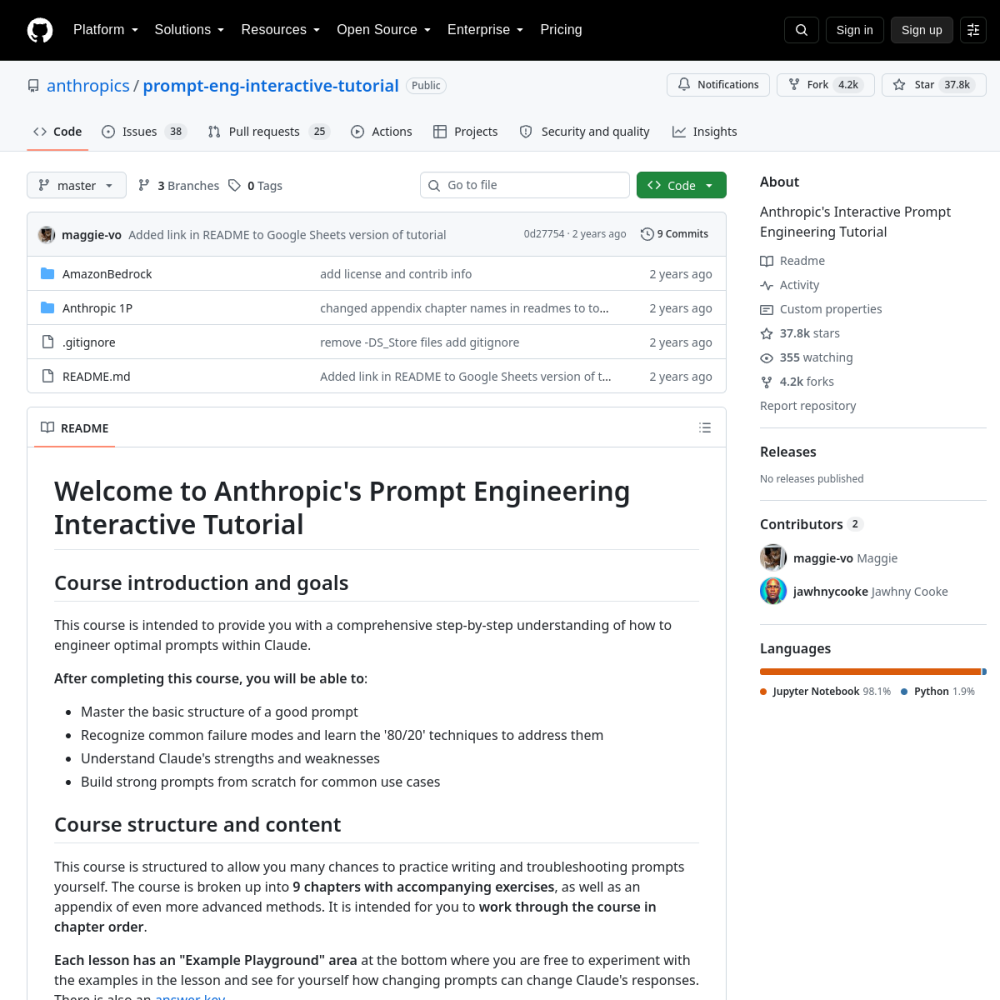
| GitHub 仓库 | anthropics/prompt-eng-interactive-tutorial |
|---|---|
| Star 关注度 | ★ 37.8k |
| Fork 衍生数 | 4.2k forks |
| 主要开发语言 | Jupyter Notebook |
| 开源协议 | MIT |
| 所属技术领域 | EDUCATION |
$ git clone https://github.com/anthropics/prompt-eng-interactive-tutorial.git
Anthropic 官方交互式提示词工程教程是目前大模型生态中极具权威性与系统性的开源教学项目。该项目以 Jupyter Notebook 为核心载体,不仅提供理论讲解,更通过“Example Playground”机制将提示词工程从玄妙的“炼丹术”转化为可量化、可复现的硬核工程学科。教程精准定位开发者在构建复杂 AI 智能体时面临的痛点,系统化拆解了 System Prompt 设计、少样本提示以及结构化输出等核心技术机制。通过 9 个进阶章节与配套练习,开发者能够深入理解 Claude 3 模型的能力边界与偏好分布,掌握解决常见失败模式的“80/20”法则。其最大的工程价值在于,它不仅教授语法,更传授架构思维。在真实生产环境中,大模型的输出质量高度依赖于提示词的上下文构建与约束逻辑。该教程通过引导开发者使用 Claude 3 Haiku 进行低成本、高频率的迭代实验,大幅降低了智能体开发的试错成本。无论是构建基于 MCP 协议的复杂工具调用,还是实现长文本场景下的精准指令遵循,该教程都为开发者提供了从底层逻辑到上层应用的完整认知框架,是构建企业级 AI 应用的必修基石。
随着大语言模型从单一的对话工具向复杂智能体架构演进,传统的提示词编写逐渐暴露出严重的工程化短板。在早期的 LLM 开发中,Prompt 往往被视为难以版本化、缺乏结构化定义的“字符串拼接艺术”,这导致智能体在调用外部 Tool 或 Skill 时缺乏统一的通信协议,极易出现指令解析失败或上下文溢出。Anthropic 推出该交互式教程的初衷,正是为了在行业层面确立提示词工程的规范标准,将开发者的经验主义转化为可复现的工程范式。
该教程的设计哲学深植于 Claude 模型的底层架构特性,针对多智能体通信死锁、沙箱执行不安全以及长上下文注意力漂移等核心痛点,提出了一套循序渐进的解决框架。它不仅强调了 System Prompt 在设定角色边界与安全约束上的绝对权威,还通过少样本与结构化输出的深度演练,解决了模型在复杂任务流中的指令遵循难题。这种从“基础结构”到“高级复杂模式”的演进路径,本质上是对智能体认知架构的重塑,为构建高可靠性的企业级 Agent 奠定了坚实的指令层基础。
该教程的技能体系直接赋能多个前沿落地场景。首先是企业级 MCP(Model Context Protocol)技能生态的构建,开发者通过掌握教程中的结构化输出与少样本技巧,能够编写出高度稳定的 Tool 描述与调用 Prompt,使得 Claude 能够精准解析外部 API 的返回结果,实现复杂工作流的自动化串联。其次是自主浏览器网页自动化,利用教程中传授的复杂多轮 Prompt 约束解析技巧,开发者可以构建出具备强抗干扰能力的 Web Agent,精准执行 DOM 树解析与动态交互操作。
在个性化长周期 Agent 记忆沉淀场景中,教程关于上下文管理与清晰指令的设计原则至关重要。开发者能够学会如何通过 System Prompt 动态注入历史记忆摘要,避免长对话中的“遗忘”或“幻觉”问题。此外,该教程非常适合需要处理复杂多轮约束解析的 SaaS 产品研发团队、致力于构建私有化大模型工具链的架构师,以及希望系统掌握 Claude 模型特性的 AI 应用开发者,帮助其在智能体指令设计上实现从 0 到 1 的跨越。
该项目的极简上手体验得益于 Jupyter Notebook 的交互式特性。开发者只需通过 Git 克隆仓库 git clone https://github.com/anthropics/prompt-eng-interactive-tutorial.git,并安装核心依赖 pip install anthropic jupyter 即可启动本地环境。教程贴心地提供了 Google Sheets 版本,但对于深度技术驱动的开发者,Jupyter 环境能提供更强大的代码调试与变量追踪能力。在使用前,只需在环境变量中配置 ANTHROPIC_API_KEY,即可开启完整的实战演练。
教程的核心交互机制在于其内置的“Example Playground”。在每个章节的底部,开发者可以直接修改 Python 代码块中的 Prompt 字符串,并实时调用 Claude 3 Haiku 模型查看输出变化。例如在基础结构章节,开发者可以通过修改 client.messages.create() 函数中的 system 与 messages 参数,直观对比不同提示词结构对模型响应质量的影响。这种“即写即跑”的模式,极大缩短了从理论认知到工程实践的转化周期。
在生产落地方面,该教程展现出了极高的工程实用性。它所倡导的“80/20”法则(即 20% 的提示词技巧解决 80% 的常见失败模式)直击企业级应用开发的痛点。通过系统化应用教程中的技巧,开发团队可显著降低 Token 消耗与 API 调用成本,并有效抑制大模型在复杂业务逻辑中的 Prompt 漂移现象。教程默认采用 Claude 3 Haiku 模型进行演示,这不仅保证了高频演练的极低延迟,更让开发者在原型验证阶段就能对生产环境的并发性能与成本控制有精准预期。
然而,该教程在实际应用中也存在一定的潜在风险与局限。首先,Haiku 模型在指令遵循上的容错率较高,开发者若过度依赖其特性,在迁移至 Sonnet 或 Opus 等更智能但行为模式不同的模型时,可能会遭遇 Prompt 效果衰减的调试成本。其次,教程虽然涵盖了沙箱执行与安全隔离的提示词层面约束,但在真实生产环境中,仍需结合底层代码级的权限控制来彻底防范 Prompt 注入攻击。开发者需在教程基础上,结合具体业务场景的上下文长度与并发要求,进行额外的工程化封装与压力测试。
作为 Anthropic 官方背书的核心教程,该项目已成为大模型生态内提示词工程的标杆,被广泛集成于主流的开源框架与行业工作流中。例如,在 LangChain 和 LlamaIndex 等主流 Agent 框架的 Claude 适配层中,其 System Prompt 的设计规范大量参考了该教程的最佳实践。同时,Anthropic 自身的 Claude for Sheets 扩展程序也是该教程理念的商业化延伸,使得非技术背景的业务人员也能在 Google Sheets 中利用结构化 Prompt 构建轻量级智能体。
在业界典型集成案例方面,众多企业级 SaaS 平台在接入 Claude API 构建 Copilot 功能时,均要求研发团队将该教程作为内部培训的基础设施。特别是在金融风控、法律文书解析等对结构化输出要求极高的领域,教程中关于 JSON 模式约束与少样本提示的章节被直接转化为生产环境的 Prompt 模板。未来,随着 MCP 协议的普及,该教程所奠定的指令约束体系将进一步成为多智能体协同通信的底层语义标准,持续引领 AI 工程化的发展趋势。
Prompt Engineering Tutorial 是基于 Jupyter Notebook 开发的知名开源 AI 项目(采用 MIT 开源协议)。Anthropic 官方交互式提示词工程教程,系统化拆解大模型提示词构建范式,助力开发者从零掌握复杂智能体指令约束与结构化输出。。随着大语言模型从单一的对话工具向复杂智能体架构演进,传统的提示词编写逐渐暴露出严重的工程化短板。在早期的 LLM 开发中,Prompt 往往被视为难以版本化、缺乏结构化定义的“字符串拼接艺术”,这导致智能体在调用外部 Tool 或 Skill 时缺乏统一的通信协议,极易出现指令解析失败或上下文溢出。Anthropic 推出该交互式教程的初衷,正是为了在行业层面确立提示词工程的规范标准,将开发者的经验主义转化为可复现的工程范式。 该教程的设计哲学深植于 Claude 模型的底层架构特性,针对多智能体通信死锁、沙箱执行不安全以及长上下文注意力漂移等核心痛点,提出了一套循序渐进的解决框架。它不仅强调了 System Prompt 在设定角色边界与安全约束上的绝对权威,还通过少样本与结构化输出的深度演练,解决了模型在复杂任务流中的指令遵循难题。这种从“基础结构”到“高级复杂模式”的演进路径,本质上是对智能体认知架构的重塑,为构建高可靠性的企业级 Agent 奠定了坚实的指令层基础。
该项目的极简上手体验得益于 Jupyter Notebook 的交互式特性。开发者只需通过 Git 克隆仓库 git clone https://github.com/anthropics/prompt-eng-interactive-tutorial.git,并安装核心依赖 pip install anthropic jupyter 即可启动本地环境。教程贴心地提供了 Google Sheets 版本,但对于深度技术驱动的开发者,Jupyter 环境能提供更强大的代码调试与变量追踪能力。在使用前,只需在环境变量中配置 ANTHROPIC_API_KEY,即可开启完整的实战演练。 教程的核心交互机制在于其内置的“Example Playground”。在每个章节的底部,开发者可以直接修改 Python 代码块中的 Prompt 字符串,并实时调用 Claude 3 Haiku 模型查看输出变化。例如在基础结构章节,开发者可以通过修改 client.messages.create() 函数中的 system 与 messages 参数,直观对比不同提示词结构对模型响应质量的影响。这种“即写即跑”的模式,极大缩短了从理论认知到工程实践的转化周期。
Prompt Engineering Tutorial 适合用于 企业级 MCP 技能生态中的 Tool 描述与调用 Prompt 标准化定义、自主浏览器网页自动化 Agent 的复杂多轮指令解析与 DOM 树结构化输出、个性化长周期 Agent 记忆沉淀场景下的上下文管理与 System Prompt 设计、AI 开发者团队内部提示词工程的系统化培训与最佳实践规范建立。其综合评分为 4.8/5 分,具备开箱即用、社区活跃、架构设计轻量等优势,能够无缝集成到现有的 AI 工作流中。
在生产落地方面,该教程展现出了极高的工程实用性。它所倡导的“80/20”法则(即 20% 的提示词技巧解决 80% 的常见失败模式)直击企业级应用开发的痛点。通过系统化应用教程中的技巧,开发团队可显著降低 Token 消耗与 API 调用成本,并有效抑制大模型在复杂业务逻辑中的 Prompt 漂移现象。教程默认采用 Claude 3 Haiku 模型进行演示,这不仅保证了高频演练的极低延迟,更让开发者在原型验证阶段就能对生产环境的并发性能与成本控制有精准预期。 然而,该教程在实际应用中也存在一定的潜在风险与局限。首先,Haiku 模型在指令遵循上的容错率较高,开发者若过度依赖其特性,在迁移至 Sonnet 或 Opus 等更智能但行为模式不同的模型时,可能会遭遇 Prompt 效果衰减的调试成本。其次,教程虽然涵盖了沙箱执行与安全隔离的提示词层面约束,但在真实生产环境中,仍需结合底层代码级的权限控制来彻底防范 Prompt 注入攻击。开发者需在教程基础上,结合具体业务场景的上下文长度与并发要求,进行额外的工程化封装与压力测试。
本地运行大型语言模型的极简工具