官网预览
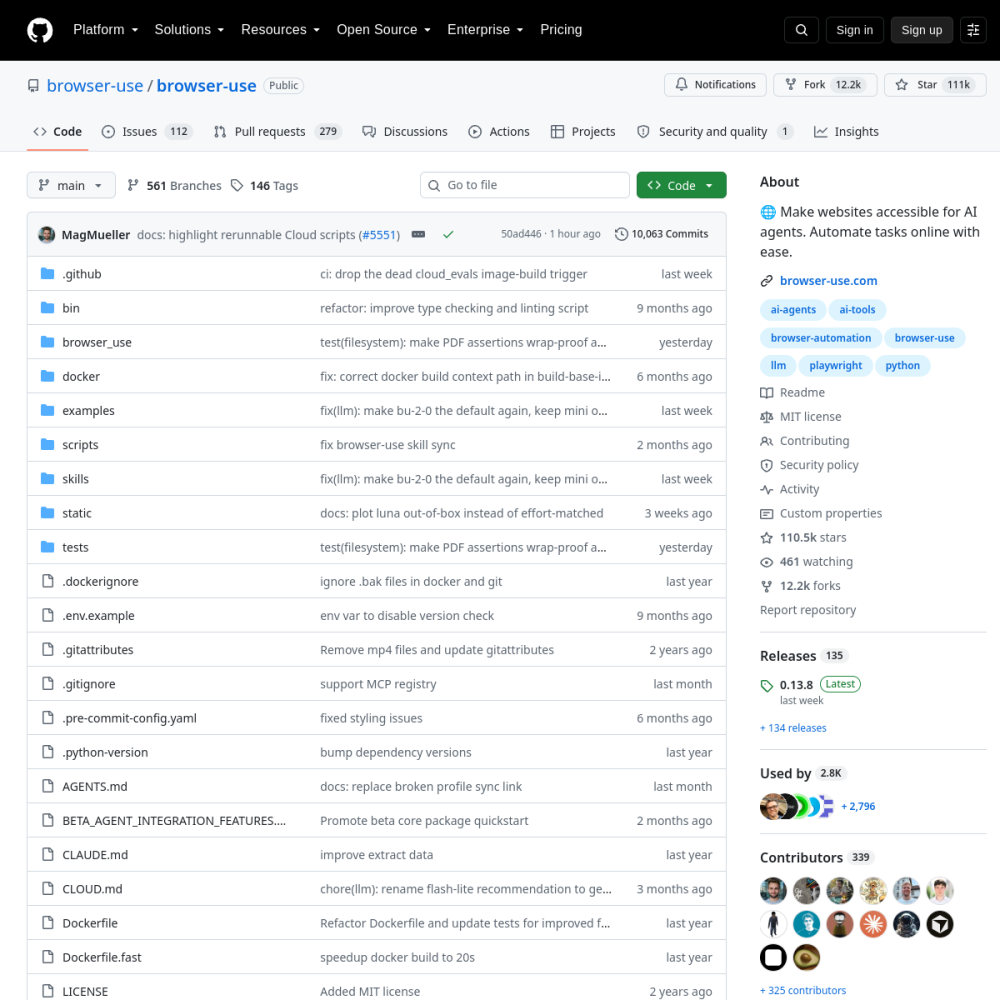
| GitHub 仓库 | browser-use/browser-use |
|---|---|
| Star 关注度 | ★ 110.9k |
| Fork 衍生数 | 12.2k forks |
| 主要开发语言 | Python |
| 开源协议 | MIT |
| 所属技术领域 | AGENTS |
$ pip install browser-use
Browser Use 是一个极具颠覆性的开源 Web Agent 框架,其核心定位是让大语言模型(LLM)化身为能够直接操作浏览器的智能体。在传统的 RPA 或自动化测试工具中,开发者往往需要通过硬编码坐标或 XPath 来定位页面元素,这种方式在面对现代动态网页(如 SPA 应用)时极其脆弱。Browser Use 巧妙地结合了视觉语言模型(VLM)的屏幕截图理解能力与 DOM 树的结构化解析,构建了一套双引擎驱动的交互机制。它不仅能让 AI 理解页面布局,还能精准提取可交互元素并生成操作指令,从而实现表单填写、数据抓取与多步导航等复杂任务。
从技术架构来看,该项目基于 Python 异步生态构建,深度集成了 Playwright 作为底层浏览器控制引擎,并原生支持 OpenAI、Anthropic、DeepSeek 等主流大模型。其核心创新在于将复杂的网页交互抽象为一套统一的 Tool/Skill 调用协议,大模型通过结构化输出(如 Pydantic 模式)直接输出动作类型(如 click、scroll、type)及目标元素索引。这种设计大幅降低了 Prompt 工程的复杂度,开发者只需用自然语言描述任务,智能体即可自主规划路径并执行。此外,项目内置了完善的沙箱机制与安全策略,有效防止了 Prompt 漂移与恶意网页注入攻击,保障了自动化流程的鲁棒性。凭借超 11 万的 Star 数,Browser Use 已成为 AI 自动化领域的标杆,为企业级 Web 自动化提供了极具工程价值的基础设施。
Browser Use 的诞生源于传统 LLM 智能体开发中普遍存在的痛点:大模型本身具备强大的推理与规划能力,但缺乏与真实物理世界(尤其是 Web 环境)交互的统一通信协议。在以往的开发模式中,开发者往往需要编写大量定制化的爬虫或 API 调用代码来为模型提供数据,这种方式不仅维护成本极高,且面对频繁更新的现代动态网页时极其脆弱。此外,传统自动化工具(如 Selenium 或 Puppeteer)依赖硬编码的选择器,一旦页面 DOM 结构发生微小变动,整个自动化流程便会崩溃。Browser Use 的设计哲学正是为了打破这种僵局,它提出不应让 AI 去适应死板的代码,而应让代码去适应 AI 的自主决策。
为了实现这一理念,Browser Use 在架构演进上做出了诸多创新。首先,它摒弃了单一的 DOM 解析路径,引入了视觉语言模型(VLM)与 DOM 树结构化提取的双引擎机制。这意味着智能体不仅能“看到”页面渲染后的视觉布局,还能“读懂”底层 HTML 的层级关系,从而大幅提升了在动态 SPA 应用中定位元素的准确率。其次,项目针对智能体缺乏外部 Tool/Skill 统一协议的问题,将所有网页交互(如点击、输入、滚动)抽象为标准化的动作原语,并通过 Pydantic 进行结构化约束,确保大模型输出的指令可被直接执行。最后,针对沙箱执行不安全与多智能体通信死锁等痛点,Browser Use 内置了严格的权限隔离机制与异步事件循环管理,确保在多标签页并发操作时不会出现资源竞争,为迈向企业级生产环境奠定了坚实的架构基础。
在核心应用场景方面,Browser Use 展现出了极高的通用性与业务价值。首先是企业级 MCP 技能生态的构建,通过将浏览器操作封装为标准化的 MCP (Model Context Protocol) 服务,企业可以让内部的各种 AI 助手直接调用 Web 资源,例如查询竞品官网价格、自动登录内部 HR 系统审批请假等。这种模式打破了传统 API 集成的数据孤岛,使得大模型能够直接处理那些没有开放 API 的老旧系统,极大地扩展了智能体的业务边界。适用于希望构建统一 AI 中台的大型企业开发团队。
其次是自主浏览器网页自动化与个性化长周期 Agent 记忆沉淀。在自动化测试与 RPA 领域,开发者只需用自然语言描述“登录某网站并下载 Q3 财报”,Browser Use 即可自主规划路径、处理弹窗与验证码,甚至能在执行过程中沉淀页面交互记忆,用于后续相似任务的复用。此外,在复杂多轮 Prompt 约束解析场景中,如处理需要跨越多个页面的多步表单提交,框架能够维持长上下文的稳定性,确保任务目标不漂移。这些特性使其非常适合数据抓取团队、QA 自动化工程师以及需要处理复杂线上工单的运维团队使用,大幅降低了脚本编写与维护的门槛。
Browser Use 的技术架构基于 Python 异步生态与 Playwright 构建,上手极为便捷。开发者首先需要通过 Python 的包管理工具安装核心库,并安装 Playwright 的浏览器依赖。核心安装命令如下:pip install browser-use,随后执行 playwright install chromium 下载所需浏览器引擎。环境准备就绪后,开发者只需配置大模型的 API Key(如 OpenAI 或 Anthropic),即可通过几行代码启动一个智能体。项目原生支持通过环境变量或配置文件加载模型凭证,确保了密钥管理的安全性。
在最小核心代码示例中,开发者首先实例化一个 Agent 对象,传入自然语言任务描述与底层大模型客户端,随后调用 agent.run() 方法即可启动自动化流程。例如:from browser_use import Agent; from langchain_openai import ChatOpenAI; agent = Agent(task="寻找并关注 GitHub 上的 trending 项目", llm=ChatOpenAI(model="gpt-4o")); await agent.run()。这种极简的 API 设计隐藏了底层复杂的 DOM 提取、视觉分析与动作映射逻辑。同时,框架支持通过 Pydantic 模式自定义输出结构,开发者可以轻松扩展特定的 Tool/Skill,例如在执行过程中注入自定义的 JavaScript 脚本或拦截网络请求,实现从 0 到 1 的高阶定制。
在生产落地与工程实用性方面,Browser Use 表现出了显著的优势,但也伴随一些潜在风险。其最大亮点在于高并发与长上下文环境下的稳定性。得益于 Python Asyncio 异步架构与 Playwright 的无头浏览器管理,框架能够高效处理多标签页并发操作,且在长周期任务中通过视觉与 DOM 双重校验机制有效抑制了 Prompt 漂移。此外,其结构化动作输出确保了指令执行的确定性,大幅降低了调试成本。开发者可以通过详细的日志追踪智能体的每一步思考与操作,快速定位执行失败的节点。
然而,在真实生产环境中仍需关注几个关键风险点。首先是沙箱安全隔离边界的问题,虽然框架内置了恶意网页注入防护,但大模型仍可能被精心构造的页面内容诱导执行危险操作(如误点击删除按钮),因此在关键业务流中仍需引入人工审核机制。其次,Browser Use 的运行强依赖于底层大模型的推理能力,在处理极其复杂的动态验证码或高度混淆的页面时,仍存在一定的失败率,需要开发者预留重试与异常处理逻辑。最后,大规模并发调用视觉模型会带来较高的 Token 消耗成本,企业在落地时需在任务复杂度与执行成本之间寻找平衡。总体而言,它是一个极具前瞻性的基础设施,但在迈向全无人值守的生产环境前,仍需完善容错与监控体系。
在业界典型集成与生态案例方面,Browser Use 已经成为众多开源 AI 智能体框架的首选 Web 交互组件。例如,在著名的 AI 自动化平台 LangChain 与 CrewAI 生态中,开发者广泛使用 Browser Use 作为核心 Tool 扩展,赋予多智能体系统直接操作浏览器的能力。在 MCP (Model Context Protocol) 生态中,Browser Use 被封装为标准的 Browser Skill,允许 Claude 等大模型通过统一协议安全地调用浏览器执行搜索与信息提取任务。这种深度集成不仅丰富了工具链,也推动了 Web Agent 在开源社区的标准化进程。
从行业客户应用现状来看,众多金融、电商与出行领域的企业已开始探索将其应用于自动化风控审核与竞品价格监控。例如,某头部出行平台利用 Browser Use 构建了自动化的航班价格巡检 Agent,每日自主浏览各大航司官网提取最低票价,无需依赖不稳定的第三方 API。未来,随着多模态大模型推理能力的进一步提升,Browser Use 有望与语音交互、实时视频流处理深度融合,催生出能够处理全动态网页交互甚至 3D 虚拟环境操作的通用智能体,进一步重塑 Web 自动化的技术格局。
Browser Use 是基于 Python 开发的知名开源 AI 项目(采用 MIT 开源协议)。Browser Use 是一个赋予大模型自主网页浏览、表单填写与自动化交互能力的开源框架,通过视觉与 DOM 解析双引擎让 AI 智能体直接操作浏览器。。Browser Use 的诞生源于传统 LLM 智能体开发中普遍存在的痛点:大模型本身具备强大的推理与规划能力,但缺乏与真实物理世界(尤其是 Web 环境)交互的统一通信协议。在以往的开发模式中,开发者往往需要编写大量定制化的爬虫或 API 调用代码来为模型提供数据,这种方式不仅维护成本极高,且面对频繁更新的现代动态网页时极其脆弱。此外,传统自动化工具(如 Selenium 或 Puppeteer)依赖硬编码的选择器,一旦页面 DOM 结构发生微小变动,整个自动化流程便会崩溃。Browser Use 的设计哲学正是为了打破这种僵局,它提出不应让 AI 去适应死板的代码,而应让代码去适应 AI 的自主决策。 为了实现这一理念,Browser Use 在架构演进上做出了诸多创新。首先,它摒弃了单一的 DOM 解析路径,引入了视觉语言模型(VLM)与 DOM 树结构化提取的双引擎机制。这意味着智能体不仅能“看到”页面渲染后的视觉布局,还能“读懂”底层 HTML 的层级关系,从而大幅提升了在动态 SPA 应用中定位元素的准确率。其次,项目针对智能体缺乏外部 Tool/Skill 统一协议的问题,将所有网页交互(如点击、输入、滚动)抽象为标准化的动作原语,并通过 Pydantic 进行结构化约束,确保大模型输出的指令可被直接执行。最后,针对沙箱执行不安全与多智能体通信死锁等痛点,Browser Use 内置了严格的权限隔离机制与异步事件循环管理,确保在多标签页并发操作时不会出现资源竞争,为迈向企业级生产环境奠定了坚实的架构基础。
Browser Use 的技术架构基于 Python 异步生态与 Playwright 构建,上手极为便捷。开发者首先需要通过 Python 的包管理工具安装核心库,并安装 Playwright 的浏览器依赖。核心安装命令如下:pip install browser-use,随后执行 playwright install chromium 下载所需浏览器引擎。环境准备就绪后,开发者只需配置大模型的 API Key(如 OpenAI 或 Anthropic),即可通过几行代码启动一个智能体。项目原生支持通过环境变量或配置文件加载模型凭证,确保了密钥管理的安全性。 在最小核心代码示例中,开发者首先实例化一个 Agent 对象,传入自然语言任务描述与底层大模型客户端,随后调用 agent.run() 方法即可启动自动化流程。例如:from browser_use import Agent; from langchain_openai import ChatOpenAI; agent = Agent(task="寻找并关注 GitHub 上的 trending 项目", llm=ChatOpenAI(model="gpt-4o")); await agent.run()。这种极简的 API 设计隐藏了底层复杂的 DOM 提取、视觉分析与动作映射逻辑。同时,框架支持通过 Pydantic 模式自定义输出结构,开发者可以轻松扩展特定的 Tool/Skill,例如在执行过程中注入自定义的 JavaScript 脚本或拦截网络请求,实现从 0 到 1 的高阶定制。
Browser Use 适合用于 企业级自动化测试与 RPA 替代:利用自然语言驱动浏览器执行复杂业务流测试,降低脚本维护成本、智能数据抓取与网页爬虫:针对反爬与动态加载页面,AI 自主探索并提取结构化数据,突破传统选择器限制、自动化表单填写与工单处理:结合大模型推理能力,实现跨系统工单流转与自动化审批操作、AI 智能体外部技能扩展:作为 MCP (Model Context Protocol) 中的核心 Browser Skill,赋予 Agent 真实世界交互能力。其综合评分为 4.8/5 分,具备开箱即用、社区活跃、架构设计轻量等优势,能够无缝集成到现有的 AI 工作流中。
在生产落地与工程实用性方面,Browser Use 表现出了显著的优势,但也伴随一些潜在风险。其最大亮点在于高并发与长上下文环境下的稳定性。得益于 Python Asyncio 异步架构与 Playwright 的无头浏览器管理,框架能够高效处理多标签页并发操作,且在长周期任务中通过视觉与 DOM 双重校验机制有效抑制了 Prompt 漂移。此外,其结构化动作输出确保了指令执行的确定性,大幅降低了调试成本。开发者可以通过详细的日志追踪智能体的每一步思考与操作,快速定位执行失败的节点。 然而,在真实生产环境中仍需关注几个关键风险点。首先是沙箱安全隔离边界的问题,虽然框架内置了恶意网页注入防护,但大模型仍可能被精心构造的页面内容诱导执行危险操作(如误点击删除按钮),因此在关键业务流中仍需引入人工审核机制。其次,Browser Use 的运行强依赖于底层大模型的推理能力,在处理极其复杂的动态验证码或高度混淆的页面时,仍存在一定的失败率,需要开发者预留重试与异常处理逻辑。最后,大规模并发调用视觉模型会带来较高的 Token 消耗成本,企业在落地时需在任务复杂度与执行成本之间寻找平衡。总体而言,它是一个极具前瞻性的基础设施,但在迈向全无人值守的生产环境前,仍需完善容错与监控体系。
本地运行大型语言模型的极简工具