官网预览
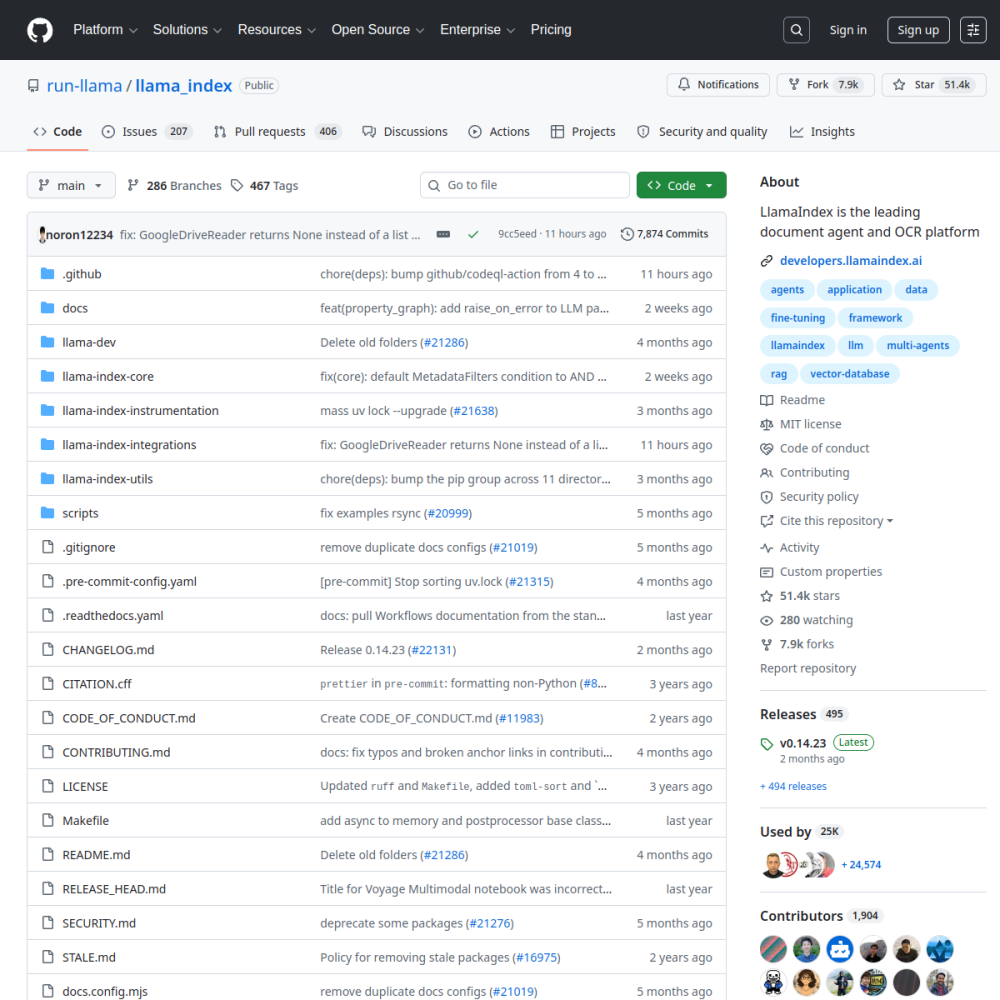
| GitHub 仓库 | run-llama/llama_index |
|---|---|
| Star 关注度 | ★ 51.9k |
| Fork 衍生数 | 8k forks |
| 主要开发语言 | Python |
| 开源协议 | MIT |
| 所属技术领域 | FRAMEWORK |
$ git clone https://github.com/run-llama/llama_index.git && cd llama_index
LlamaIndex 定位为「LLM 与私有数据之间的桥梁」,把文档加载、切分、索引、检索、生成的全链路标准化,是构建 RAG 应用的主流选择之一。相较 LangChain 的「通用框架」定位,它在数据连接与检索质量上更专精。
核心能力包括 200+ 数据连接器(Notion、Confluence、SQL、PDF 等)、多种索引结构(向量、树、关键词、知识图谱)、查询引擎与路由、高级 RAG 策略(子问题、递归、融合排序),以及 LlamaParse 文档解析与 LlamaCloud 托管服务。
亮点是数据源集成与 RAG 高级模式覆盖度高,对「检索质量」做了大量工程化封装;不足是与 LangChain 功能重叠区域越来越多,部分高级 API 抽象层层嵌套,调试时需要翻多层源码,版本间偶有 breaking change。
适用场景:企业知识库问答、文档智能检索、需要复杂 RAG 策略的应用。简单 demo 用 LangChain 更轻,重数据场景用 LlamaIndex 更顺。
LlamaIndex 定位为连接大语言模型与私有数据之间的桥梁,旨在解决 LLM 无法直接访问用户私有数据的核心痛点。该项目由 LlamaIndex 团队维护,将文档加载、切分、索引、检索及生成的全链路流程进行了标准化封装。
其设计灵感源于对检索增强生成架构的深入理解,试图在数据连接与检索质量上提供更专精的解决方案。相较于通用框架,它更专注于数据索引与查询引擎的底层优化,是构建 RAG 应用的主流选择之一。
该项目适用于企业知识库问答场景,能够高效整合 Notion、Confluence 及 SQL 等多种数据源。对于需要处理大量非结构化文档的智能检索任务,LlamaIndex 提供了标准化的处理流程,确保数据被有效索引。
适合需要复杂 RAG 策略的应用开发,例如涉及子问题分解、递归检索或融合排序的高级场景。简单演示项目可能更适合轻量级框架,但重数据场景下 LlamaIndex 更为顺手,能显著提升检索准确性。
用户可通过 pip 安装 llama-index 包,快速构建索引并连接大模型接口。安装完成后,只需几行代码即可加载本地 PDF 或网页数据,并构建向量索引。这一过程简化了数据预处理步骤,让开发者能专注于业务逻辑。
首次运行通常涉及配置 LLM 提供商密钥,随后调用查询引擎进行对话测试。官方文档提供了从数据加载到查询引擎的完整示例,便于开发者快速验证流程并理解核心概念。
综合评分为 4.0 分,其中功能性与活跃度得分较高,表明其在生产环境中具备较强的可用性。项目内置了 200 多个数据连接器及多种索引结构,对检索质量做了大量工程化封装,降低了开发难度。
不足之处在于部分高级 API 抽象层层嵌套,调试时可能需要翻阅多层源码,增加了维护成本。此外,版本间偶有 breaking change,与 LangChain 的功能重叠区域也在逐渐增多,选型时需权衡具体需求。
常见于需要处理多源异构数据的企业级应用中,如内部文档管理系统或智能客服系统。项目生态中的 LlamaParse 文档解析服务与 LlamaCloud 托管服务,进一步降低了生产部署门槛,适合对稳定性有要求的场景。
在开源社区中,它常作为 RAG 应用的标准组件被集成,支持向量、树、关键词及知识图谱等多种索引结构。开发者可依据具体业务需求,灵活选择查询引擎与路由策略,以满足不同的检索精度要求。
LlamaIndex 是基于 Python 开发的知名开源 AI 项目(采用 MIT 开源协议)。LLM 数据框架与 RAG 引擎。LlamaIndex 定位为连接大语言模型与私有数据之间的桥梁,旨在解决 LLM 无法直接访问用户私有数据的核心痛点。该项目由 LlamaIndex 团队维护,将文档加载、切分、索引、检索及生成的全链路流程进行了标准化封装。 其设计灵感源于对检索增强生成架构的深入理解,试图在数据连接与检索质量上提供更专精的解决方案。相较于通用框架,它更专注于数据索引与查询引擎的底层优化,是构建 RAG 应用的主流选择之一。
用户可通过 pip 安装 llama-index 包,快速构建索引并连接大模型接口。安装完成后,只需几行代码即可加载本地 PDF 或网页数据,并构建向量索引。这一过程简化了数据预处理步骤,让开发者能专注于业务逻辑。 首次运行通常涉及配置 LLM 提供商密钥,随后调用查询引擎进行对话测试。官方文档提供了从数据加载到查询引擎的完整示例,便于开发者快速验证流程并理解核心概念。
LlamaIndex 适合用于 企业知识库问答、文档智能检索、复杂 RAG 策略应用。其综合评分为 4.0/5 分,具备开箱即用、社区活跃、架构设计轻量等优势,能够无缝集成到现有的 AI 工作流中。
综合评分为 4.0 分,其中功能性与活跃度得分较高,表明其在生产环境中具备较强的可用性。项目内置了 200 多个数据连接器及多种索引结构,对检索质量做了大量工程化封装,降低了开发难度。 不足之处在于部分高级 API 抽象层层嵌套,调试时可能需要翻阅多层源码,增加了维护成本。此外,版本间偶有 breaking change,与 LangChain 的功能重叠区域也在逐渐增多,选型时需权衡具体需求。
本地运行大型语言模型的极简工具