官网预览
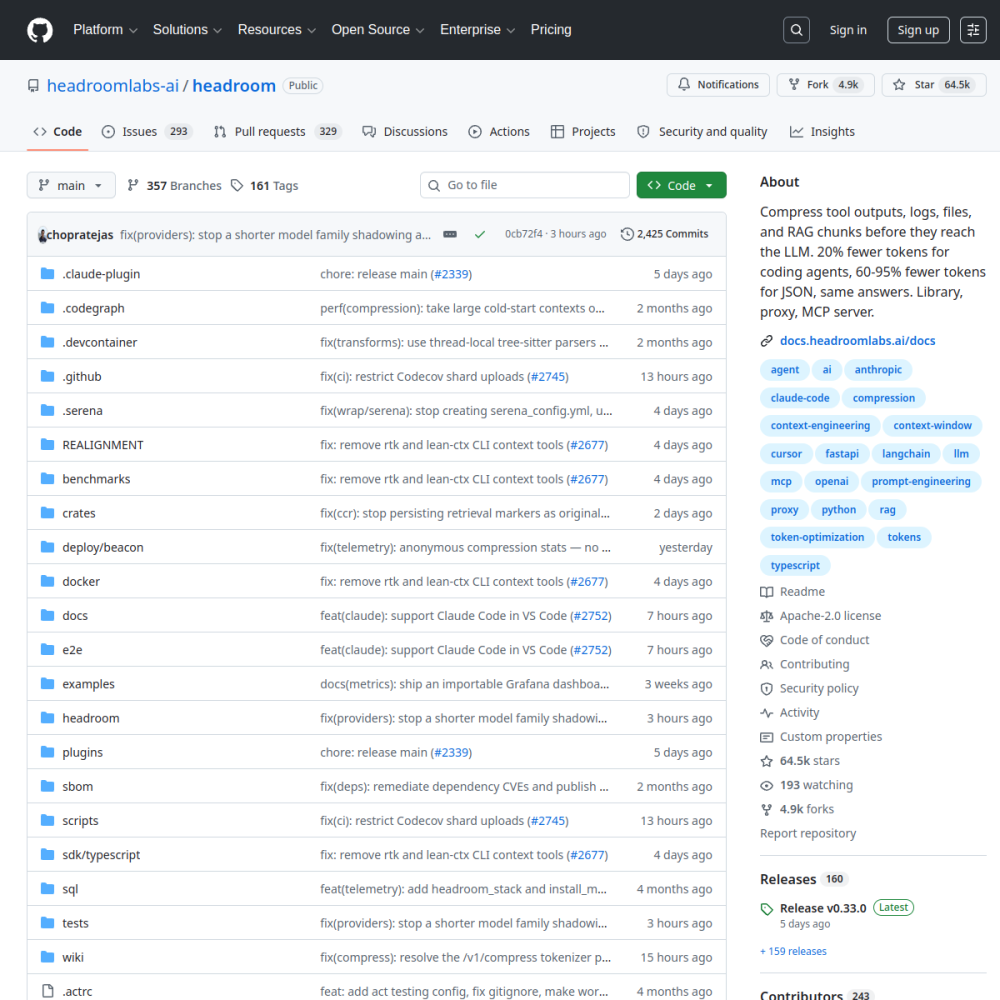
| GitHub 仓库 | headroomlabs-ai/headroom |
|---|---|
| Star 关注度 | ★ 67.5k |
| Fork 衍生数 | 5.2k forks |
| 主要开发语言 | Python |
| 开源协议 | Apache-2.0 |
| 所属技术领域 | OTHER |
$ git clone https://github.com/headroomlabs-ai/headroom.git && cd headroom
该项目定位为 LLM 上下文工程领域的优化工具,旨在解决大模型输入成本高昂及上下文窗口受限的问题。它位于数据源与模型之间,通过智能压缩机制处理工具输出、日志、文件及 RAG 块,确保在减少 Token 用量的同时不损失关键信息。
核心能力体现在多形态部署上,用户可根据需求选择 Python 库、代理服务器或 MCP 服务器模式。项目宣称针对编码 Agent 可减少 20% Token,针对 JSON 数据压缩率可达 60-95%,且保持答案一致性。这种灵活性使其能无缝集成到现有的 LangChain、FastAPI 或 Claude Code 工作流中。
亮点在于其显著的 Token 优化效果及广泛的生态兼容性,支持 OpenAI、Anthropic 等主流模型。潜在不足可能在于压缩过程带来的额外延迟,以及在极端复杂逻辑下对语义保留的边界测试。总体而言,它是降低 LLM 应用成本、提升上下文利用效率的实用解决方案。
headroom 由 headroomlabs-ai 团队创建,定位为 LLM 上下文工程领域的优化工具。它旨在解决大模型输入成本高昂及上下文窗口受限的核心痛点。
项目位于数据源与模型之间,通过智能压缩机制处理工具输出、日志及 RAG 块,确保减少 Token 用量的同时不损失关键信息,灵感来源于对上下文效率的追求。
编码 Agent 上下文优化是典型场景之一,项目宣称可减少 20% Token 消耗。RAG 系统长文本处理也是主要适用领域,针对 JSON 数据压缩率可达 60-95%。
日志分析任务同样受益于该工具,能在保持答案一致性的前提下大幅降低输入成本。适合需要集成 LangChain、FastAPI 或 Claude Code 工作流的开发者,帮助他们优化现有流程。
用户可根据需求选择 Python 库、代理服务器或 MCP 服务器模式进行部署。这种多形态设计使其能无缝集成到现有的 LangChain、FastAPI 或 Claude Code 工作流中。
安装完成后,工具即可位于数据源与模型之间开始处理输入,无需复杂配置。
综合评分 4.5 分,功能与易用性表现突出,文档评分 4.0 分。亮点在于显著的 Token 优化效果及广泛的生态兼容性,支持 OpenAI、Anthropic 等主流模型,生态兼容性广泛。
潜在不足可能在于压缩过程带来的额外延迟,以及在极端复杂逻辑下对语义保留的边界测试。综上,它是降低 LLM 应用成本、提升上下文利用效率的实用解决方案,值得技术团队评估。
该项目常见于需要降低 LLM 应用成本、提升上下文利用效率的场景。它支持 OpenAI、Anthropic 等主流模型,适合集成到现有的 LangChain、FastAPI 或 Claude Code 工作流中。
虽然未提及具体知名公司案例,但其技术架构适用于各类编码 Agent 与 RAG 系统,具备较高的通用性。
headroom 是基于 Python 开发的知名开源 AI 项目(采用 Apache-2.0 开源协议)。LLM 输入压缩工具,减少 Token 消耗并保持答案一致性。。headroom 由 headroomlabs-ai 团队创建,定位为 LLM 上下文工程领域的优化工具。它旨在解决大模型输入成本高昂及上下文窗口受限的核心痛点。 项目位于数据源与模型之间,通过智能压缩机制处理工具输出、日志及 RAG 块,确保减少 Token 用量的同时不损失关键信息,灵感来源于对上下文效率的追求。
用户可根据需求选择 Python 库、代理服务器或 MCP 服务器模式进行部署。这种多形态设计使其能无缝集成到现有的 LangChain、FastAPI 或 Claude Code 工作流中。 安装完成后,工具即可位于数据源与模型之间开始处理输入,无需复杂配置。
headroom 适合用于 编码 Agent 上下文优化、RAG 系统长文本处理、日志分析任务。其综合评分为 4.5/5 分,具备开箱即用、社区活跃、架构设计轻量等优势,能够无缝集成到现有的 AI 工作流中。
综合评分 4.5 分,功能与易用性表现突出,文档评分 4.0 分。亮点在于显著的 Token 优化效果及广泛的生态兼容性,支持 OpenAI、Anthropic 等主流模型,生态兼容性广泛。 潜在不足可能在于压缩过程带来的额外延迟,以及在极端复杂逻辑下对语义保留的边界测试。综上,它是降低 LLM 应用成本、提升上下文利用效率的实用解决方案,值得技术团队评估。
本地运行大型语言模型的极简工具