官网预览
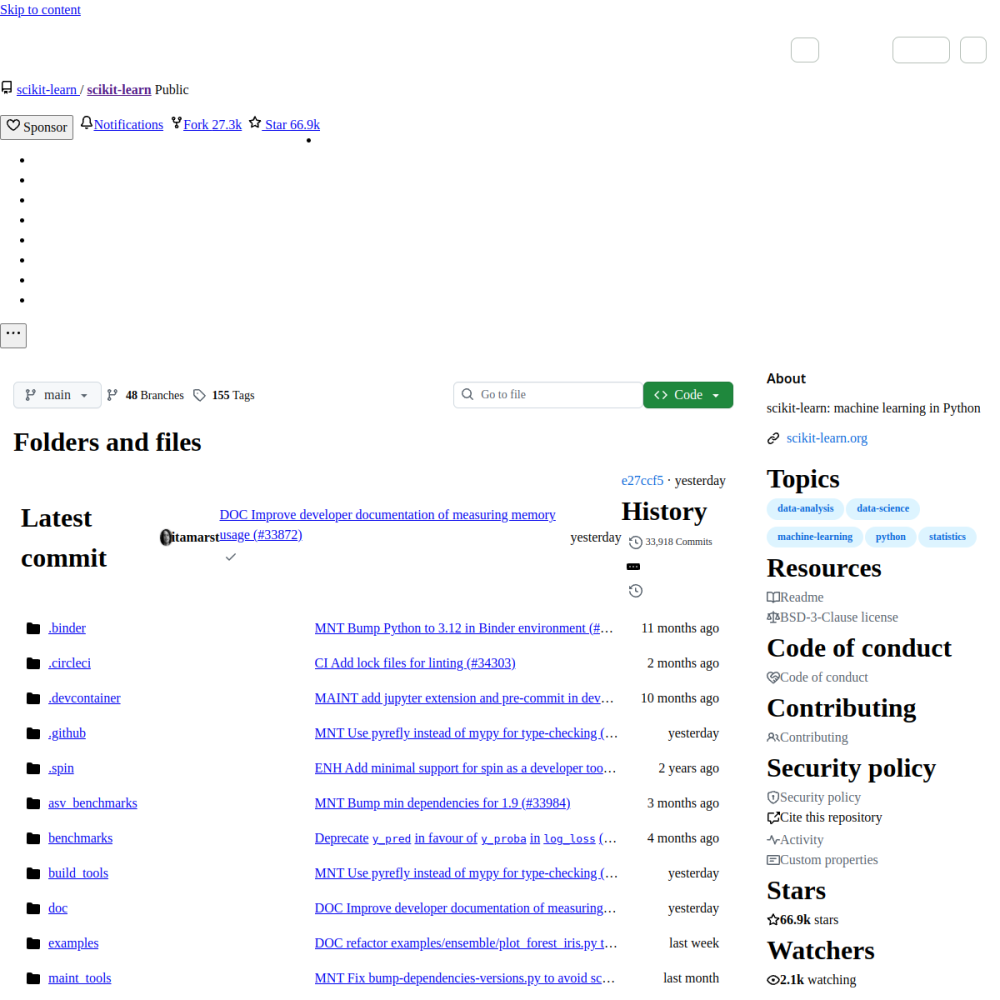
| GitHub 仓库 | scikit-learn/scikit-learn |
|---|---|
| Star 关注度 | ★ 67.1k |
| Fork 衍生数 | 27.3k forks |
| 主要开发语言 | Python |
| 开源协议 | BSD-3-Clause |
| 所属技术领域 | OTHER |
$ git clone https://github.com/scikit-learn/scikit-learn.git && cd scikit-learn
scikit-learn 是 Python 数据科学栈中的核心组件,建立在 NumPy 和 SciPy 之上,旨在为各种应用场景提供简单高效的机器学习工具。它填补了底层数值计算库与高层应用之间的空白,成为许多数据科学家的首选入门工具。
该库涵盖了分类、回归、聚类和降维等多种经典算法,同时提供了数据预处理、特征选择、模型评估及参数调优等完整流程支持。其统一的 API 设计使得不同算法之间的切换和比较变得非常便捷,降低了学习成本。
项目的优势在于其文档详尽且示例丰富,社区生态成熟,稳定性极高。不足之处在于它主要面向传统机器学习,对于大规模深度学习任务或超大数据集的处理效率不如专门的深度学习框架或分布式计算工具。
总体而言,scikit-learn 非常适合用于结构化数据的分析、模型原型验证以及生产环境中的传统机器学习任务。它是构建可靠机器学习流水线的重要基石,尤其适合需要快速迭代和验证想法的场景。
scikit-learn 是 Python 数据科学栈中的核心组件,建立在 NumPy 和 SciPy 之上。它旨在为各种应用场景提供简单高效的机器学习工具,填补了底层数值计算库与高层应用之间的空白。
该项目采用 BSD-3-Clause 协议,鼓励社区贡献与商业使用,成为许多数据科学家的首选入门工具。其设计灵感来源于简化复杂算法的实现过程,让开发者能够专注于数据本身而非底层数学细节。
该库非常适合用于结构化数据的分析、模型原型验证以及生产环境中的传统机器学习任务。它是构建可靠机器学习流水线的重要基石,尤其适合需要快速迭代和验证想法的场景。
典型应用场景包括分类、回归、聚类和降维等多种经典算法的开发。同时提供了数据预处理、特征选择、模型评估及参数调优等完整流程支持,适合数据科学家和工程师使用。
对于机器学习教学与原型快速搭建,其统一的 API 设计使得不同算法之间的切换和比较变得非常便捷。这降低了学习成本,让初学者能够迅速理解不同模型的特性,加速从理论到实践的转化。
用户可以通过 pip 或 conda 包管理器轻松安装该库,例如执行 pip install scikit-learn。安装完成后,即可在 Python 环境中直接导入相关模块开始使用,无需复杂的配置。
首次运行通常涉及加载内置数据集并训练一个简单模型。例如使用鸢尾花数据集进行分类预测,只需几行代码即可完成数据加载、模型训练与评估。
官方文档提供了丰富的示例代码,用户可以直接复制运行以验证环境配置。这种低门槛的启动方式有助于开发者快速熟悉库的基本功能,缩短上手时间。
综合评分显示该项目在功能与文档方面表现优异,稳定性极高,总评分达到 4.8 分。其统一的 API 设计使得不同算法之间的切换和比较变得非常便捷,降低了学习成本。
不足之处在于它主要面向传统机器学习,对于大规模深度学习任务或超大数据集的处理效率不如专门的深度学习框架。因此,它更适合中小规模数据的生产环境任务,而非超大规模分布式计算。
该库常见于各类数据科学工作流程中,常与 Pandas 和 Matplotlib 配合使用。许多企业将其作为传统机器学习任务的标准工具,用于构建可靠的预测模型。
在开源生态中,它是许多高级分析工具的依赖基础,常集成于 Jupyter Notebook 等交互环境中。虽然具体商业案例未公开披露,但其广泛的用户基础表明其在工业界具有极高的认可度。
scikit-learn 是基于 Python 开发的知名开源 AI 项目(采用 BSD-3-Clause 开源协议)。scikit-learn 是 Python 中最广泛使用的机器学习库之一。。scikit-learn 是 Python 数据科学栈中的核心组件,建立在 NumPy 和 SciPy 之上。它旨在为各种应用场景提供简单高效的机器学习工具,填补了底层数值计算库与高层应用之间的空白。 该项目采用 BSD-3-Clause 协议,鼓励社区贡献与商业使用,成为许多数据科学家的首选入门工具。其设计灵感来源于简化复杂算法的实现过程,让开发者能够专注于数据本身而非底层数学细节。
用户可以通过 pip 或 conda 包管理器轻松安装该库,例如执行 pip install scikit-learn。安装完成后,即可在 Python 环境中直接导入相关模块开始使用,无需复杂的配置。 首次运行通常涉及加载内置数据集并训练一个简单模型。例如使用鸢尾花数据集进行分类预测,只需几行代码即可完成数据加载、模型训练与评估。 官方文档提供了丰富的示例代码,用户可以直接复制运行以验证环境配置。这种低门槛的启动方式有助于开发者快速熟悉库的基本功能,缩短上手时间。
scikit-learn 适合用于 传统机器学习模型开发与验证、数据预处理与特征工程流程、机器学习教学与原型快速搭建。其综合评分为 4.8/5 分,具备开箱即用、社区活跃、架构设计轻量等优势,能够无缝集成到现有的 AI 工作流中。
综合评分显示该项目在功能与文档方面表现优异,稳定性极高,总评分达到 4.8 分。其统一的 API 设计使得不同算法之间的切换和比较变得非常便捷,降低了学习成本。 不足之处在于它主要面向传统机器学习,对于大规模深度学习任务或超大数据集的处理效率不如专门的深度学习框架。因此,它更适合中小规模数据的生产环境任务,而非超大规模分布式计算。
本地运行大型语言模型的极简工具