官网预览
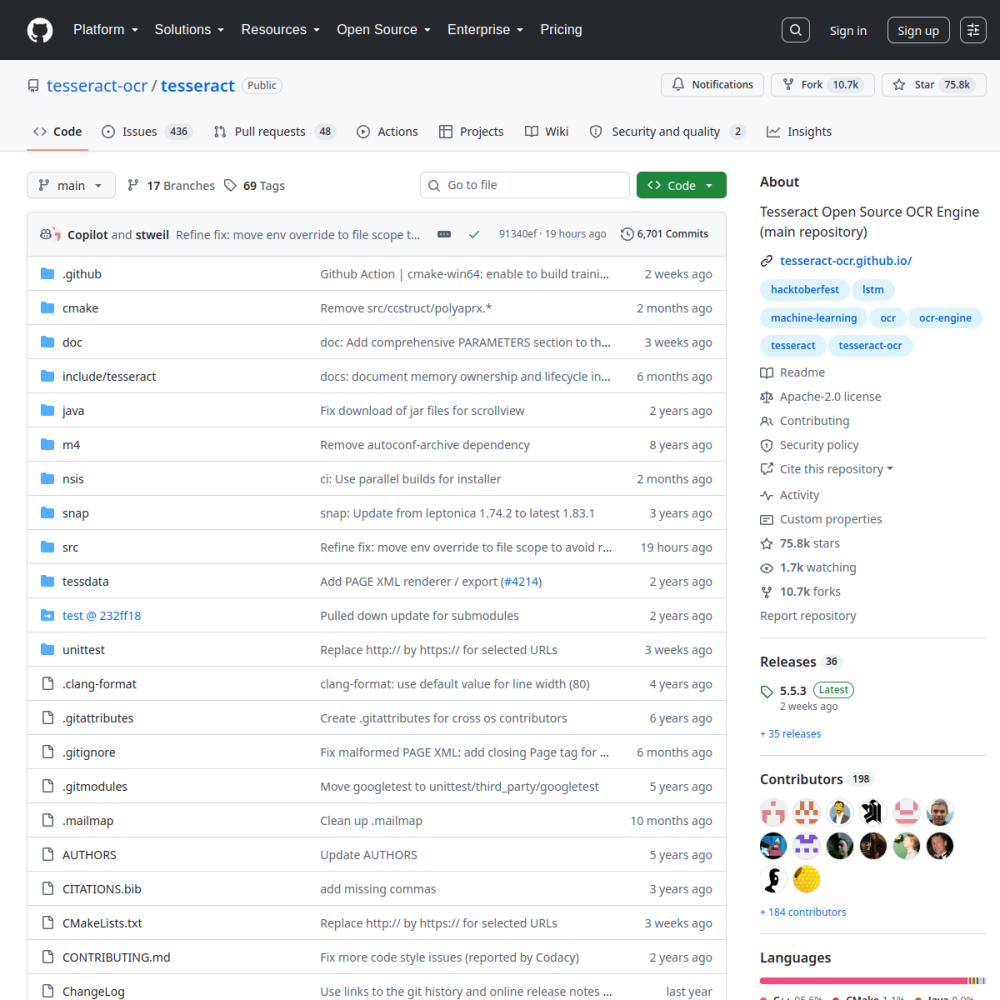
| GitHub 仓库 | tesseract-ocr/tesseract |
|---|---|
| Star 关注度 | ★ 76.2k |
| Fork 衍生数 | 10.8k forks |
| 主要开发语言 | C++ |
| 开源协议 | Apache-2.0 |
| 所属技术领域 | OTHER |
$ git clone https://github.com/tesseract-ocr/tesseract.git && cd tesseract
Tesseract 是一款历史悠久且广泛应用的开源光学字符识别(OCR)引擎,最初由惠普开发,现由谷歌维护。作为该领域的事实标准之一,它在开源社区中拥有极高的知名度和庞大的用户基础,适合需要低成本文本提取方案的开发者。
该项目的核心能力在于其强大的多语言支持以及基于 LSTM 神经网络的识别架构。相比早期版本,新版 Tesseract 在识别准确率上有了显著提升,能够处理多种字体和排版格式。它提供了命令行工具及多种编程语言的 API 接口,便于集成到不同的软件系统中。
尽管功能强大,Tesseract 也存在一定的局限性。对于复杂版面分析或低质量扫描件,其效果可能不如商业级 OCR 服务。此外,模型训练和配置相对复杂,新手用户可能需要投入一定时间学习参数调整。不过,其活跃的社区和持续的更新保证了项目的生命力。
总体而言,Tesseract 是构建自定义 OCR 系统的理想基石。它特别适合那些对数据隐私敏感、无法使用云端 API 或预算有限的场景。通过合理的预处理和后处理,用户可以在本地环境中实现高效的文本数字化流程。
Tesseract 是一款历史悠久且广泛应用的开源光学字符识别引擎,最初由惠普开发,现由谷歌维护。作为该领域的事实标准之一,它在开源社区中拥有极高的知名度和庞大的用户基础。
该项目旨在解决从图像中提取文本的问题,核心基于 C++ 开发,适合需要低成本文本提取方案的开发者。相比早期版本,新版基于 LSTM 神经网络架构,在识别准确率上有了显著提升,能够处理多种字体和排版格式。
该项目特别适合文档数字化与归档场景,帮助用户将纸质资料转化为可编辑文本。对于需要批量处理票据信息提取的企业,它能提供稳定的本地化解决方案,减少对外部服务的依赖。
在对数据隐私敏感、无法使用云端 API 或预算有限的场景中,Tesseract 是构建自定义 OCR 系统的理想基石。通过合理的预处理和后处理,用户可以在本地环境中实现高效的文本数字化流程,满足离线需求。
用户可获取命令行工具,随后使用简单的指令即可对图片进行识别。例如运行工具指向输入图片并指定输出文件,即可快速获取文本结果。
除了命令行,项目还提供了多种编程语言的 API 接口,便于集成到不同的软件系统中。开发者可根据自身技术栈选择合适的绑定库进行二次开发,降低集成门槛,提升开发效率。
综合评分显示该项目功能与活跃度较高,功能评分达 4.5 分,能够处理多种字体和排版格式。开源免费且社区活跃的特点保证了项目的生命力,文档评分为 4.0 分,提供了基本的参考支持。
对于复杂版面分析或低质量扫描件,其效果可能不如商业级 OCR 服务,易用性评分为 3.5 分。此外,模型训练和配置相对复杂,新手用户可能需要投入一定时间学习参数调整,但社区支持有助于解决问题。
由于缺乏具体商业案例披露,该项目常见于各类本地化文本识别系统的底层引擎。许多开源文档处理工具链将其作为核心组件来实现文字提取功能,利用其成熟的算法基础。
在需要离线运行的环境中,开发者常利用其 Apache-2.0 协议优势进行商业集成。它常被用于构建无需上传数据至云端的隐私保护型应用,满足合规性要求,保障数据安全。
tesseract 是基于 C++ 开发的知名开源 AI 项目(采用 Apache-2.0 开源协议)。知名开源 OCR 引擎,基于 C++ 开发,支持多种语言文本识别。。Tesseract 是一款历史悠久且广泛应用的开源光学字符识别引擎,最初由惠普开发,现由谷歌维护。作为该领域的事实标准之一,它在开源社区中拥有极高的知名度和庞大的用户基础。 该项目旨在解决从图像中提取文本的问题,核心基于 C++ 开发,适合需要低成本文本提取方案的开发者。相比早期版本,新版基于 LSTM 神经网络架构,在识别准确率上有了显著提升,能够处理多种字体和排版格式。
用户可获取命令行工具,随后使用简单的指令即可对图片进行识别。例如运行工具指向输入图片并指定输出文件,即可快速获取文本结果。 除了命令行,项目还提供了多种编程语言的 API 接口,便于集成到不同的软件系统中。开发者可根据自身技术栈选择合适的绑定库进行二次开发,降低集成门槛,提升开发效率。
tesseract 适合用于 文档数字化与归档、批量票据信息提取、本地化文本识别系统。其综合评分为 4.5/5 分,具备开箱即用、社区活跃、架构设计轻量等优势,能够无缝集成到现有的 AI 工作流中。
综合评分显示该项目功能与活跃度较高,功能评分达 4.5 分,能够处理多种字体和排版格式。开源免费且社区活跃的特点保证了项目的生命力,文档评分为 4.0 分,提供了基本的参考支持。 对于复杂版面分析或低质量扫描件,其效果可能不如商业级 OCR 服务,易用性评分为 3.5 分。此外,模型训练和配置相对复杂,新手用户可能需要投入一定时间学习参数调整,但社区支持有助于解决问题。
本地运行大型语言模型的极简工具