官网预览
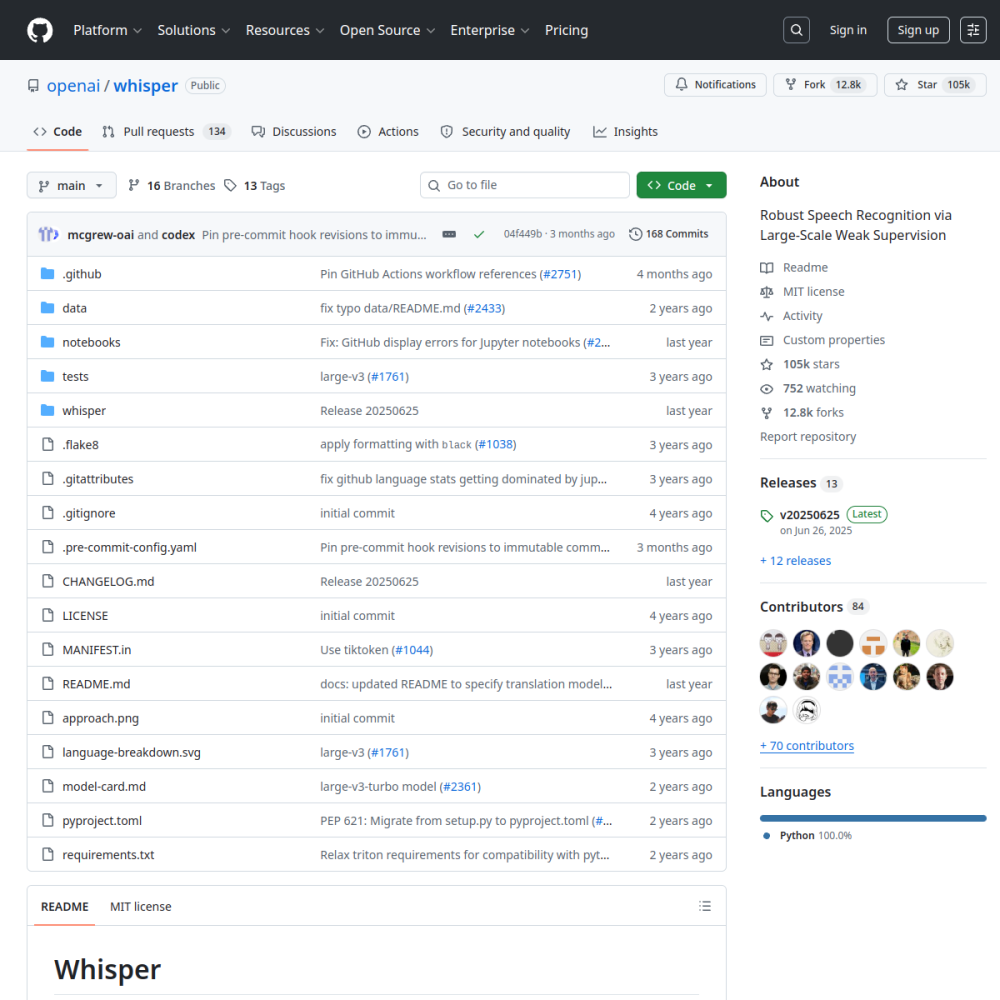
| GitHub 仓库 | openai/whisper |
|---|---|
| Star 关注度 | ★ 107.9k |
| Fork 衍生数 | 13.1k forks |
| 主要开发语言 | Python |
| 开源协议 | MIT |
| 所属技术领域 | MULTIMODAL |
$ whisper audio.mp3 --model base
Whisper 是 OpenAI 在 2022 年开源的多语言语音识别模型,凭借在 68 万小时多语言数据上的训练,至今仍是开源 ASR 的强基线。它的鲁棒性优于多数同期模型,对口音、噪声和混响有较好容忍度。
核心能力包括多语言语音转文字、语种识别、口语翻译(X→英文)、时间戳对齐,以及 tiny/base/small/medium/large 多档模型规模。社区衍生出 faster-whisper(CTranslate2 加速)、whisper.cpp(C++ 推理)、whisperX(词级时间戳与说话人分离)等生态。
亮点是模型质量与多语言覆盖在开源圈仍然能打,生态衍生项目丰富;不足是官方仓库更新缓慢(已两年未发版),长音频需自行分段避免幻觉,标点与时间戳在快速模型上不够稳定。
适用场景:视频字幕生成、会议与播客转写、低成本多语言 ASR 服务。需要词级精度或说话人分离时建议直接用 whisperX。
Whisper 由 OpenAI 于 2022 年开源,旨在构建一个鲁棒的多语言语音识别系统。其训练数据涵盖 68 万小时多语言音频,覆盖 99 种语言,通过 Transformer 架构实现端到端语音转文字能力。
该项目解决了传统 ASR 模型在口音、噪声和混响环境下识别率下降的问题,同时支持语种识别和口语翻译功能,为多语言场景提供了统一解决方案。
视频字幕自动生成场景中,Whisper 可快速处理多语言视频内容,输出带时间戳的转录文本,适合影视制作和内容创作者使用。
会议与播客转写需求中,其抗噪能力能有效处理多人对话和背景杂音,生成结构化文本记录,提升信息整理效率。
需要低成本多语言 ASR 服务的开发者可直接调用模型,避免依赖商业 API,尤其适合资源有限的初创团队或研究项目。
通过 pip 安装 whisper 包后,可使用命令行工具直接处理音频文件:whisper audio.mp3 --model base。模型会自动下载并输出转录结果。
Python 开发者可导入库进行自定义调用,例如加载 medium 模型处理长音频时建议分段输入,避免内存溢出或幻觉问题。
综合评分 4.5/5 显示其功能成熟度高,多语言覆盖和鲁棒性在开源 ASR 领域仍属领先,适合对精度要求不极端的生产环境。
不足在于官方仓库更新停滞,长音频需自行切分处理,且快速模型(如 tiny)的标点与时间戳稳定性较弱,需结合 whisperX 等衍生工具优化。
视频平台常采用 Whisper 生成多语言字幕,例如 YouTube 的自动字幕功能底层可能集成类似技术,降低人工标注成本。
会议工具如 Otter.ai 的开源替代方案中,Whisper 被用于构建实时转录模块,配合 whisperX 实现说话人分离和词级时间戳对齐。
Whisper 是基于 Python 开发的知名开源 AI 项目(采用 MIT 开源协议)。OpenAI 开源语音识别模型。Whisper 由 OpenAI 于 2022 年开源,旨在构建一个鲁棒的多语言语音识别系统。其训练数据涵盖 68 万小时多语言音频,覆盖 99 种语言,通过 Transformer 架构实现端到端语音转文字能力。 该项目解决了传统 ASR 模型在口音、噪声和混响环境下识别率下降的问题,同时支持语种识别和口语翻译功能,为多语言场景提供了统一解决方案。
通过 pip 安装 whisper 包后,可使用命令行工具直接处理音频文件:whisper audio.mp3 --model base。模型会自动下载并输出转录结果。 Python 开发者可导入库进行自定义调用,例如加载 medium 模型处理长音频时建议分段输入,避免内存溢出或幻觉问题。
Whisper 适合用于 视频字幕自动生成、会议播客转写、多语言 ASR 服务。其综合评分为 4.5/5 分,具备开箱即用、社区活跃、架构设计轻量等优势,能够无缝集成到现有的 AI 工作流中。
综合评分 4.5/5 显示其功能成熟度高,多语言覆盖和鲁棒性在开源 ASR 领域仍属领先,适合对精度要求不极端的生产环境。 不足在于官方仓库更新停滞,长音频需自行切分处理,且快速模型(如 tiny)的标点与时间戳稳定性较弱,需结合 whisperX 等衍生工具优化。
本地运行大型语言模型的极简工具