官网预览
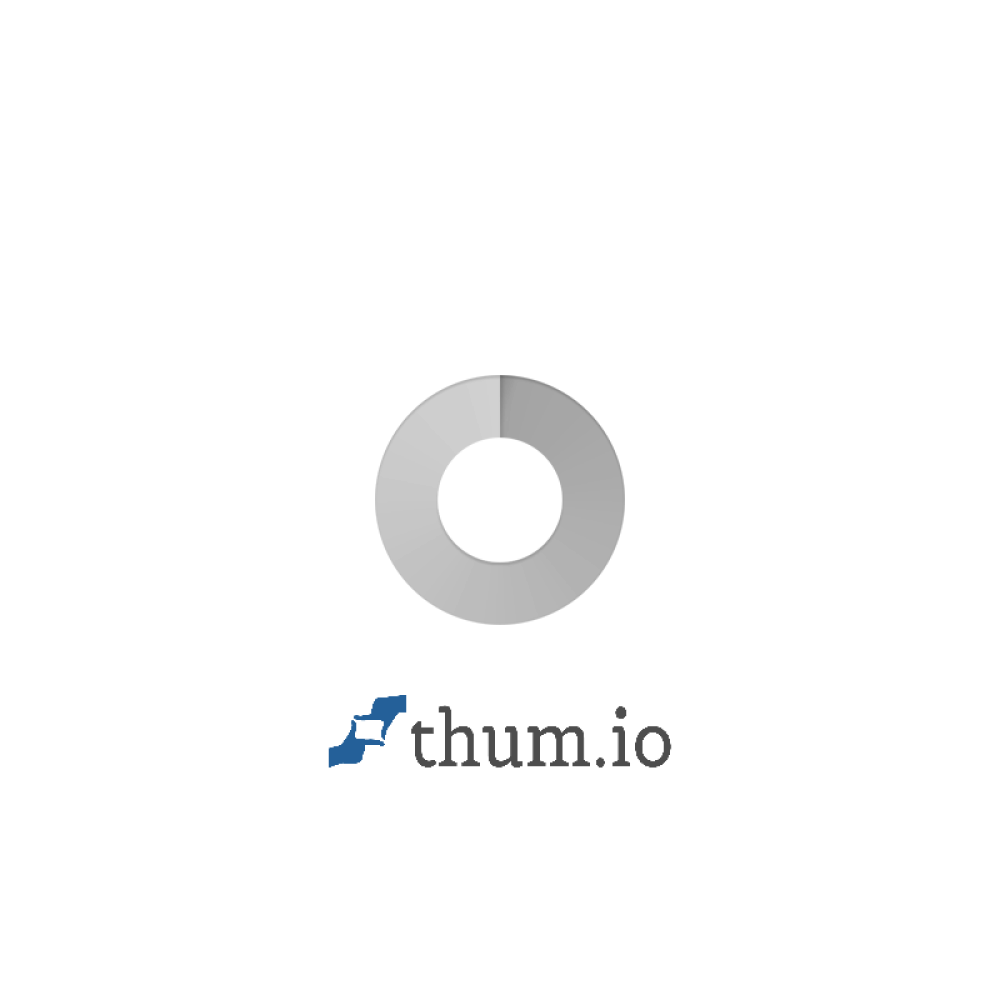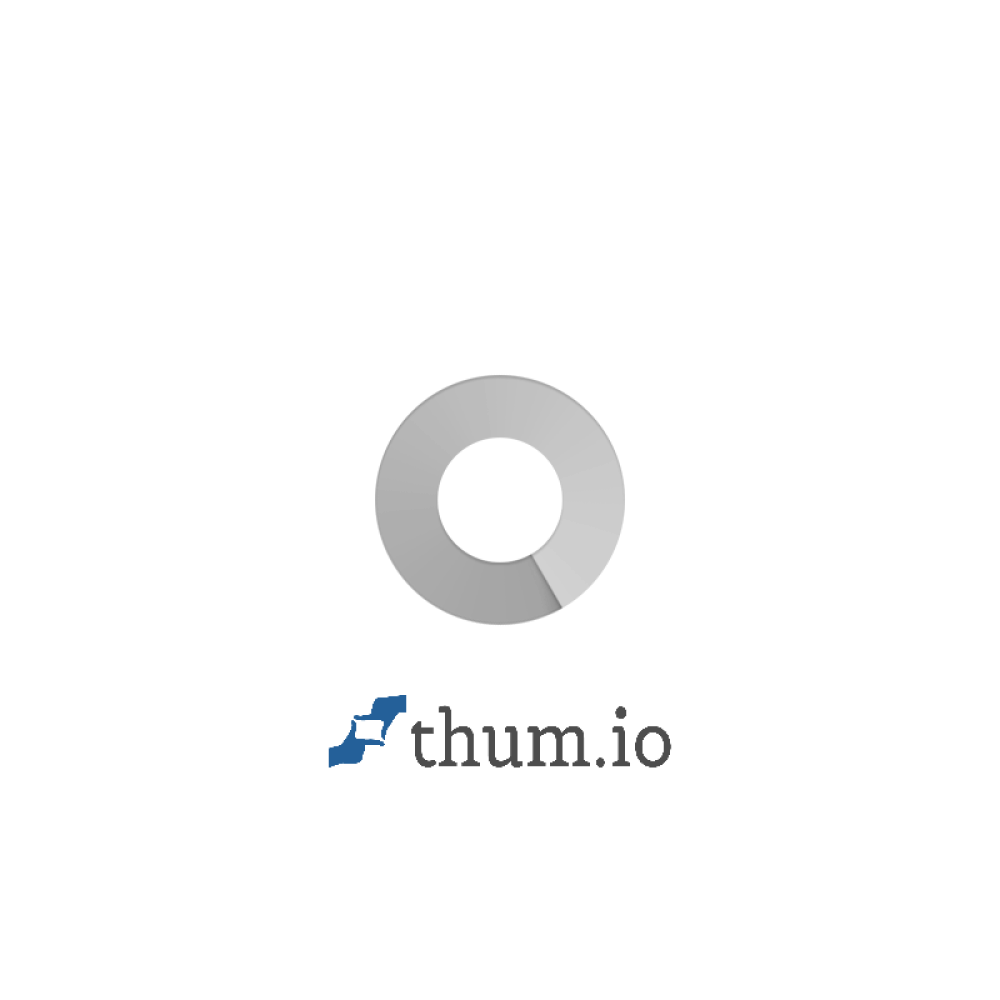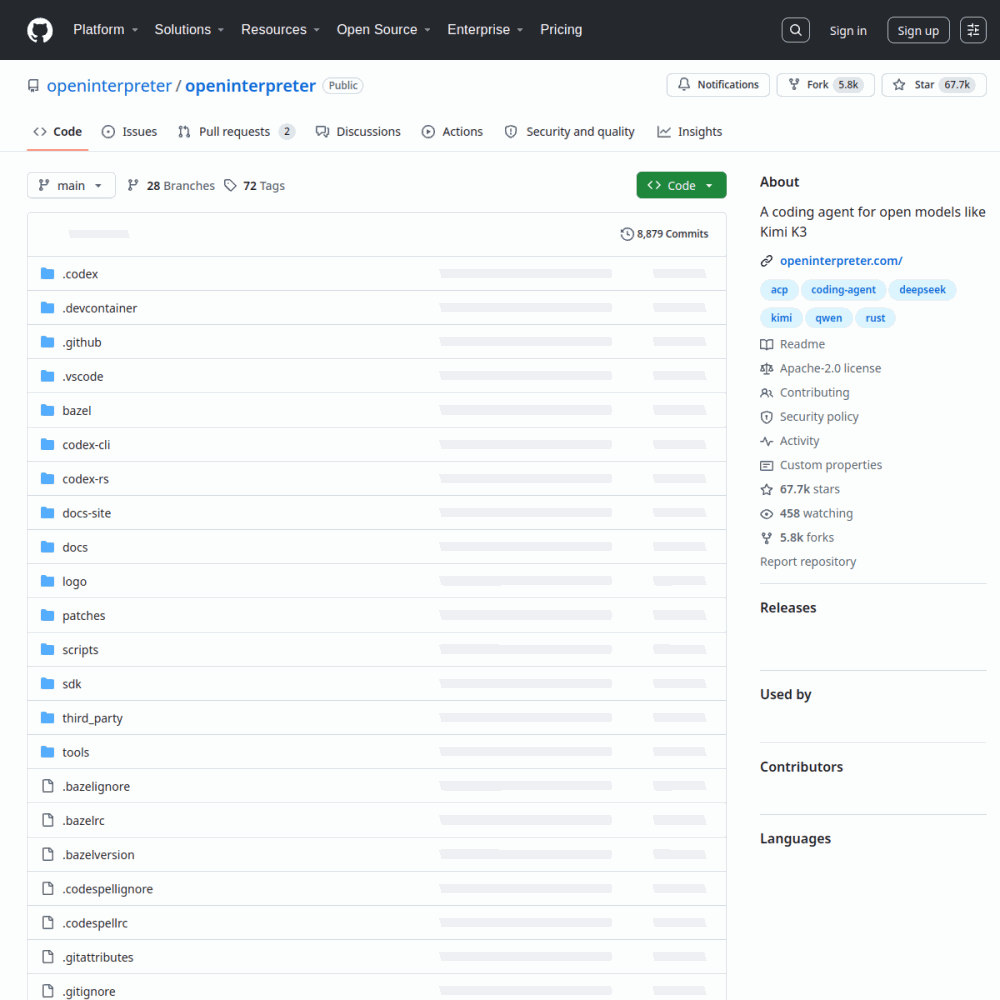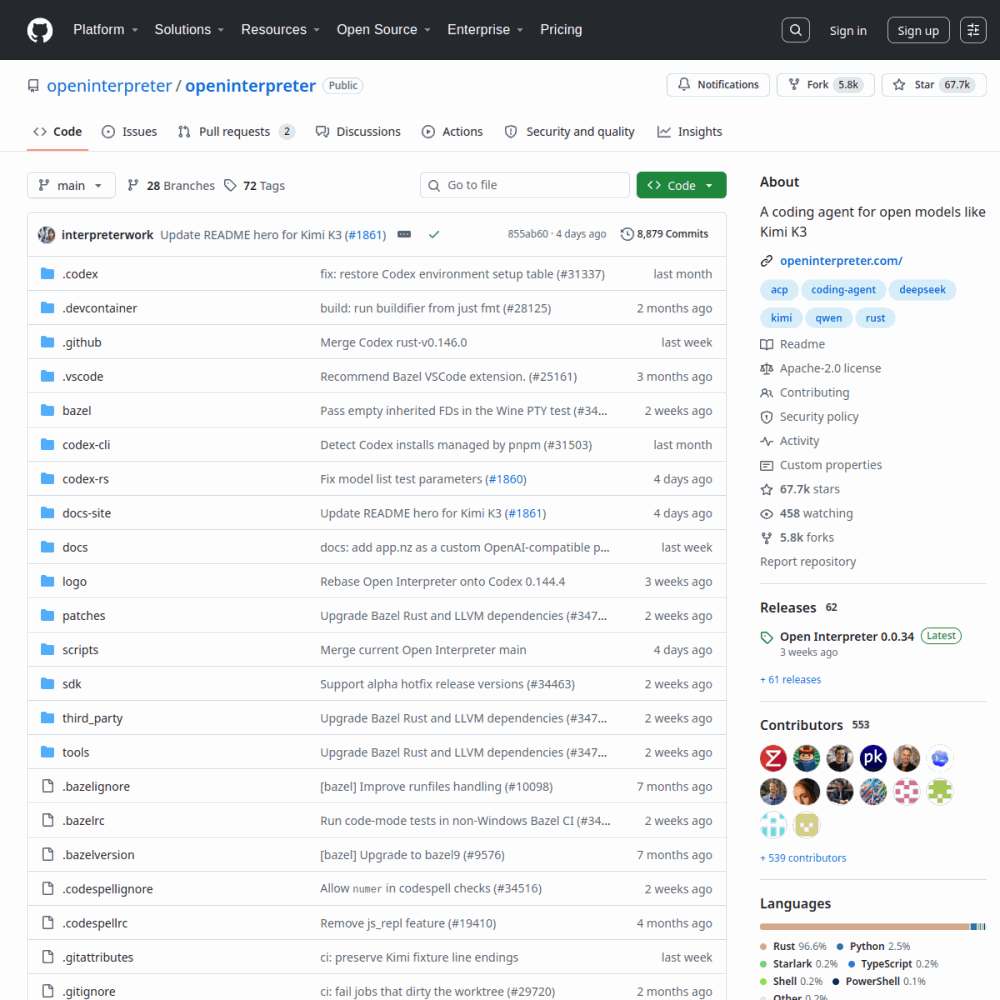
| GitHub 仓库 | OpenInterpreter/open-interpreter |
|---|---|
| Star 关注度 | ★ 68.1k |
| Fork 衍生数 | 5.9k forks |
| 主要开发语言 | Rust |
| 开源协议 | Apache-2.0 |
| 所属技术领域 | AGENTS |
$ cargo install openinterpreter
<h1 align="center">Open Interpreter</h1>
<p align="center">A coding agent optimized for low-cost models. <a href="https://www.openinterpreter.com/blog/open-interpreter?utm_source=github&utm_medium=referral&utm_campaign=readme&utm_content=hero_text"><strong>Blog post ↗</strong></a></p>
<p align="center">
<b>English</b> • <a href="README_ES.md">Español</a> • <a href="README_ZH.md">简体中文</a>
</p>
<p align="center">
<a href="https://discord.gg/Hvz9Axh84z"><img alt="Discord" src="ht
Open Interpreter 是一个专注于优化低成本开源模型的编码代理工具,由 OpenInterpreter 团队开发。其设计初衷是解决传统编码代理在资源受限模型上效率不足的问题,通过轻量化架构适配 Kimi K3、DeepSeek 等开放模型。
项目灵感来源于对开源模型在代码生成场景中实用性的探索,旨在降低开发者对高算力模型的依赖,同时保持代码生成的准确性与灵活性。
适用于需要本地化部署编码辅助工具的开发团队,尤其适合预算有限但需频繁处理代码生成任务的小型项目。开发者可通过本地模型快速迭代原型,减少云端 API 调用成本。
教育场景中可用于编程教学,学生通过本地模型练习代码调试与生成,避免网络延迟或隐私泄露风险。此外,支持多语言模型(如 Qwen)的特性使其在国际化开发环境中具备适配性。
适合需要实时代码补全或自动化脚本生成的场景,例如 DevOps 工具链集成或快速原型开发。其 Rust 实现保证了执行效率,适合对性能敏感的任务。
安装需通过 Cargo 包管理器完成:运行 cargo install openinterpreter 后,配置本地模型路径(如 Ollama 或 DeepSeek 客户端)。首次运行前需确保模型文件已下载至指定目录。
启动后通过命令行输入自然语言指令,例如 openinterpreter generate --prompt '创建一个Python爬虫脚本'。系统会自动调用配置的模型生成代码,并支持实时调试与修改。
综合评分 4.0/5 表明其在功能完整性、文档质量及易用性方面表现均衡。核心优势在于对低算力模型的优化,适合资源受限环境下的日常开发辅助。
不足在于对复杂逻辑代码的生成精度依赖模型能力,且社区生态尚处早期阶段。建议用于简单脚本生成或教学场景,生产环境需结合人工审核。
常见于本地开发环境集成,例如与 Ollama 搭配实现离线代码生成,或嵌入 VS Code 插件提供实时补全功能。部分团队将其用于自动化测试脚本的批量生成。
在教育领域,有高校将其部署为编程实验平台的后端服务,学生通过自然语言描述需求即可生成基础代码框架,降低入门门槛。
openinterpreter 是基于 Rust 开发的知名开源 AI 项目(采用 Apache-2.0 开源协议)。A coding agent for open models like Kimi K3。Open Interpreter 是一个专注于优化低成本开源模型的编码代理工具,由 OpenInterpreter 团队开发。其设计初衷是解决传统编码代理在资源受限模型上效率不足的问题,通过轻量化架构适配 Kimi K3、DeepSeek 等开放模型。 项目灵感来源于对开源模型在代码生成场景中实用性的探索,旨在降低开发者对高算力模型的依赖,同时保持代码生成的准确性与灵活性。
安装需通过 Cargo 包管理器完成:运行 cargo install openinterpreter 后,配置本地模型路径(如 Ollama 或 DeepSeek 客户端)。首次运行前需确保模型文件已下载至指定目录。 启动后通过命令行输入自然语言指令,例如 openinterpreter generate --prompt '创建一个Python爬虫脚本'。系统会自动调用配置的模型生成代码,并支持实时调试与修改。
openinterpreter 适合用于 。其综合评分为 4.0/5 分,具备开箱即用、社区活跃、架构设计轻量等优势,能够无缝集成到现有的 AI 工作流中。
综合评分 4.0/5 表明其在功能完整性、文档质量及易用性方面表现均衡。核心优势在于对低算力模型的优化,适合资源受限环境下的日常开发辅助。 不足在于对复杂逻辑代码的生成精度依赖模型能力,且社区生态尚处早期阶段。建议用于简单脚本生成或教学场景,生产环境需结合人工审核。
本地运行大型语言模型的极简工具