官网预览
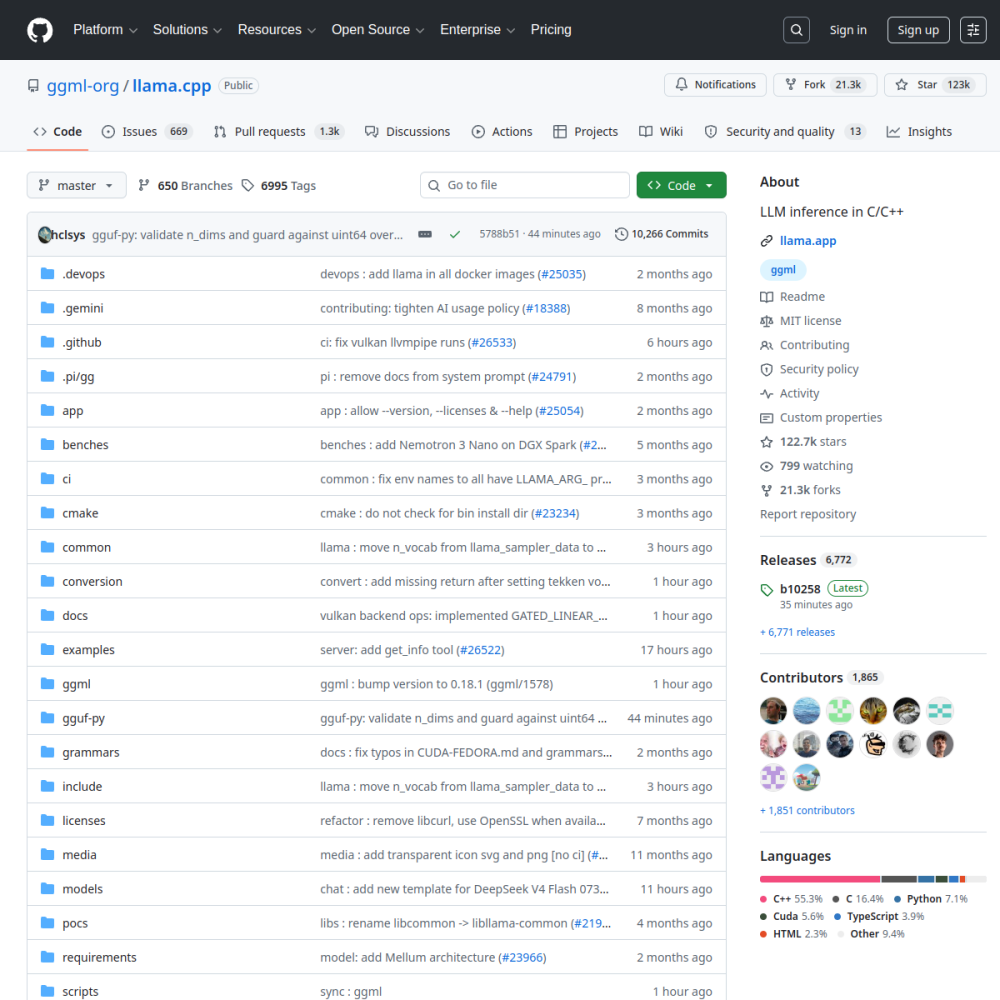
| GitHub 仓库 | ggerganov/llama.cpp |
|---|---|
| Star 关注度 | ★ 125.5k |
| Fork 衍生数 | 22.1k forks |
| 主要开发语言 | C++ |
| 开源协议 | MIT |
| 所属技术领域 | INFERENCE |
$ ./llama-cli -m model.gguf -p 'Hello'
llama.cpp 是本地 LLM 推理的事实标准,用纯 C++ 重写 LLaMA 架构,零依赖、单文件编译即可运行,是几乎所有本地推理工具(Ollama、LM Studio 等)的底层引擎。它把推理性能压榨做到了极致,CPU、GPU、NPU 通吃。
核心能力包括 GGUF 模型格式(已成为开源权重分发的事实标准)、CUDA/Metal/Vulkan/SYCL 多后端、KV cache 量化、Flash Attention、 speculative decoding,以及 server / cli / embedding 多种调用形态。对量化(Q4_K_M、Q5_K_M 等)支持是同类项目中最全的。
亮点是低配硬件也能跑起 70B 模型,跨平台移植性极强;不足是 API 偏底层,普通用户需要自行处理模型下载、量化、参数调优,上手门槛明显高于 Ollama 这类封装层。
适用场景:边缘设备与嵌入式推理、自建推理服务后端、为上层应用提供底层引擎。追求开箱即用者建议直接用 Ollama。
llama.cpp 由开发者 ggerganov 创建,旨在解决本地大语言模型推理效率问题。项目以纯 C++ 重写 LLaMA 架构,通过零依赖、单文件编译实现跨平台部署,成为本地推理生态的底层技术基石。
其设计灵感源于对现有推理框架资源消耗过高的反思,通过极致优化内存管理与计算流程,使低配设备也能运行大规模模型。项目开源后迅速被社区采纳,形成 GGUF 模型格式等事实标准。
适用于边缘设备与嵌入式系统的本地推理场景,例如在树莓派或工业控制器上部署轻量级 AI 服务。开发者可通过其多后端支持(CUDA/Metal/Vulkan)灵活适配不同硬件环境。
企业级用户可将其作为自建推理服务的后端引擎,结合量化技术降低硬件成本。研究人员则利用其完整的量化格式支持(如 Q4_K_M)进行模型压缩实验,探索性能与精度的平衡点。
通过 CMake 编译项目后,用户可直接运行示例程序。例如执行 ./llama-cli -m model.gguf -p 'Hello' 即可启动命令行推理,无需额外依赖安装。
模型需预先转换为 GGUF 格式,官方提供 Python 转换脚本。首次运行建议从社区维护的量化模型库下载预编译权重文件,确保兼容性与性能优化。
综合评分 4.5/5 反映其技术成熟度:功能维度满分得益于量化支持与多后端覆盖,但文档与易用性评分偏低。API 设计偏向底层控制,普通用户需自行处理模型下载、参数调优等流程。
生产环境中,其 KV cache 量化与 Flash Attention 实现显著提升吞吐量,适合高并发场景。但缺乏封装层导致集成复杂度较高,建议搭配 Ollama 等工具链使用以降低开发门槛。
Ollama 与 LM Studio 等主流本地推理工具均基于 llama.cpp 构建,前者将其封装为容器化服务,后者提供图形化界面。这些上层应用通过调用其核心引擎实现跨平台模型管理。
在嵌入式 AI 领域,常见于智能摄像头、边缘网关等设备的本地推理模块。开发者通过裁剪模型参数与启用量化,在 ARM 架构设备上实现实时文本生成与语音识别功能。
llama.cpp 是基于 C++ 开发的知名开源 AI 项目(采用 MIT 开源协议)。C++ 实现的高效 LLM 推理引擎。llama.cpp 由开发者 ggerganov 创建,旨在解决本地大语言模型推理效率问题。项目以纯 C++ 重写 LLaMA 架构,通过零依赖、单文件编译实现跨平台部署,成为本地推理生态的底层技术基石。 其设计灵感源于对现有推理框架资源消耗过高的反思,通过极致优化内存管理与计算流程,使低配设备也能运行大规模模型。项目开源后迅速被社区采纳,形成 GGUF 模型格式等事实标准。
通过 CMake 编译项目后,用户可直接运行示例程序。例如执行 ./llama-cli -m model.gguf -p 'Hello' 即可启动命令行推理,无需额外依赖安装。 模型需预先转换为 GGUF 格式,官方提供 Python 转换脚本。首次运行建议从社区维护的量化模型库下载预编译权重文件,确保兼容性与性能优化。
llama.cpp 适合用于 边缘设备本地推理、自建推理服务后端、嵌入式 AI 部署。其综合评分为 4.5/5 分,具备开箱即用、社区活跃、架构设计轻量等优势,能够无缝集成到现有的 AI 工作流中。
综合评分 4.5/5 反映其技术成熟度:功能维度满分得益于量化支持与多后端覆盖,但文档与易用性评分偏低。API 设计偏向底层控制,普通用户需自行处理模型下载、参数调优等流程。 生产环境中,其 KV cache 量化与 Flash Attention 实现显著提升吞吐量,适合高并发场景。但缺乏封装层导致集成复杂度较高,建议搭配 Ollama 等工具链使用以降低开发门槛。
本地运行大型语言模型的极简工具