官网预览
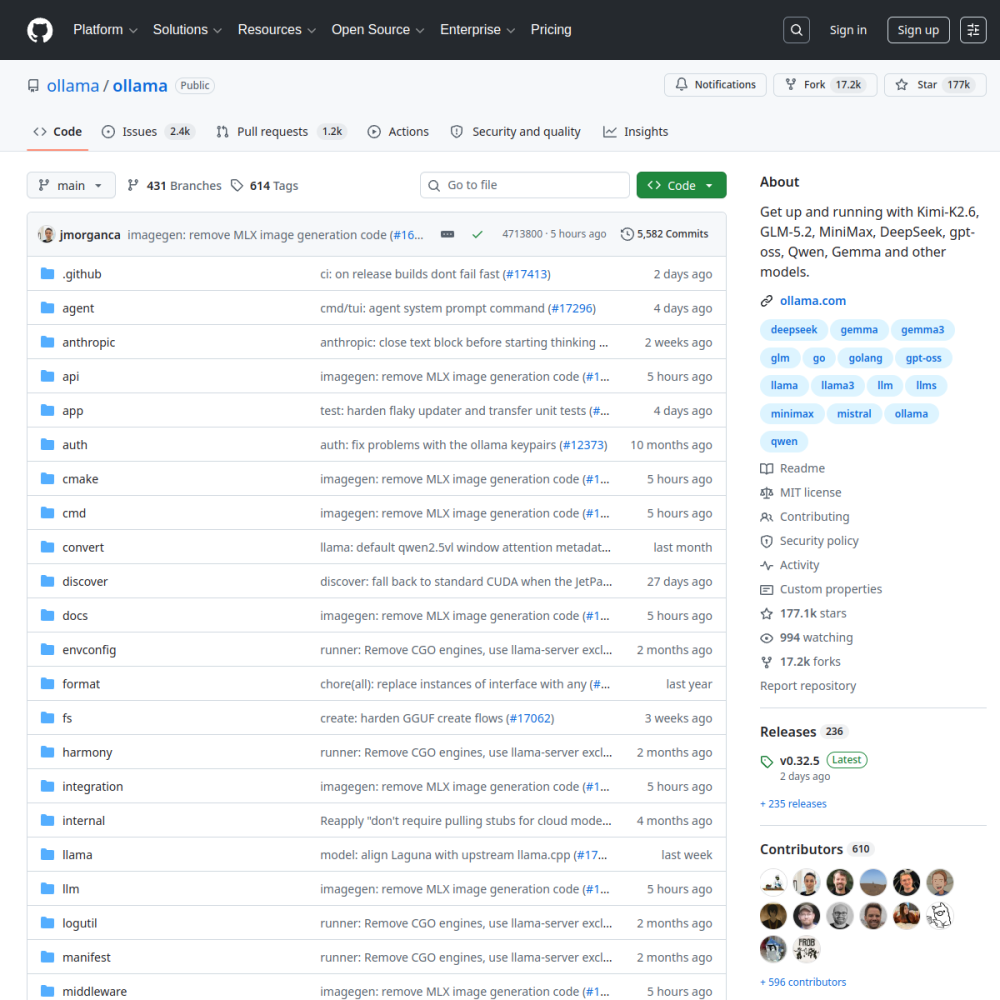
| GitHub 仓库 | ollama/ollama |
|---|---|
| Star 关注度 | ★ 179.4k |
| Fork 衍生数 | 17.5k forks |
| 主要开发语言 | Go |
| 开源协议 | MIT |
| 所属技术领域 | INFERENCE |
$ ollama run llama3
Ollama 把本地大模型部署压缩成「一行命令拉模型、一行命令起服务」的极简体验,是个人开发者和私有环境首选的本地 LLM 入口。它通过 Modelfile 统一管理模型权重、提示词与参数,把复杂的 llama.cpp 调用包装成 Docker 式的直观流程。
核心能力包括内置模型库(Llama 3、Qwen、Gemma、Mistral 等开箱即用)、兼容 OpenAI 的 REST API、多模态视觉模型支持,以及跨 macOS/Linux/Windows 的一致体验。GPU 加速在 Apple Silicon 和 NVIDIA CUDA 上均开箱可用。
亮点在于上手成本几乎为零,ollama run llama3 即可对话;不足是量化选项偏少(默认仅提供少量 GGUF 量化版本),高级用户对 KV 缓存、批处理等参数的可控性较弱,不适合追求极限吞吐的生产场景。
适用场景:个人开发机的本地推理与原型验证、内网隔离环境下的私有 LLM 服务、教学演示与模型对比评测。不建议作为高并发生产推理后端。
Ollama 由 ollama 团队创建,旨在解决本地部署大型语言模型时配置复杂、依赖繁琐的问题。项目将 llama.cpp 的核心能力封装为简洁的命令行工具,通过 Modelfile 统一管理模型权重、提示词与参数,形成类似 Docker 的标准化流程。
该项目灵感来源于容器化技术对开发效率的提升,将模型部署压缩为「拉取-运行」两步操作。其设计目标是为个人开发者与私有环境提供开箱即用的本地 LLM 入口,同时保持跨平台一致性。
适用于个人开发机的本地推理与原型验证,开发者可通过一行命令快速测试不同模型效果。内网隔离环境下的私有 LLM 服务部署也高度依赖其轻量级架构,无需暴露外部网络接口。
教学场景中常用于模型对比演示,学生可通过 Modelfile 直观理解参数调整对输出的影响。但因其资源调度机制限制,不建议用于高并发生产推理后端。
安装仅需执行官方提供的 shell 脚本,支持 macOS/Linux/Windows 一键完成。安装后通过 ollama run llama3 即可启动交互式对话,无需额外配置环境变量。
首次运行会自动下载模型权重至本地缓存,后续调用速度显著提升。用户可通过 ollama list 查看已安装模型,使用 ollama serve 启动兼容 OpenAI 的 REST API 服务。
综合评分 4.5/5 反映其易用性优势:内置 Llama 3、Qwen 等主流模型,Apple Silicon 与 NVIDIA CUDA 加速开箱可用。API 兼容 OpenAI 生态,便于现有工具链迁移。
局限性在于量化选项较少,默认仅提供少量 GGUF 版本。高级用户对 KV 缓存、批处理等底层参数的控制能力有限,难以满足生产环境对吞吐量的极致要求。
Open WebUI 等本地 AI 应用默认集成 Ollama 作为后端服务,用户可通过 Web 界面直接调用本地模型。常见于开发者构建私有知识库问答系统时,作为底层推理引擎使用。
在教育领域,高校实验室常采用其部署教学用模型,学生可安全访问本地化 LLM 进行 NLP 实验。社区项目中多用于快速验证模型微调效果,避免云端 API 调用成本。
Ollama 是基于 Go 开发的知名开源 AI 项目(采用 MIT 开源协议)。本地运行大型语言模型的极简工具。Ollama 由 ollama 团队创建,旨在解决本地部署大型语言模型时配置复杂、依赖繁琐的问题。项目将 llama.cpp 的核心能力封装为简洁的命令行工具,通过 Modelfile 统一管理模型权重、提示词与参数,形成类似 Docker 的标准化流程。 该项目灵感来源于容器化技术对开发效率的提升,将模型部署压缩为「拉取-运行」两步操作。其设计目标是为个人开发者与私有环境提供开箱即用的本地 LLM 入口,同时保持跨平台一致性。
安装仅需执行官方提供的 shell 脚本,支持 macOS/Linux/Windows 一键完成。安装后通过 ollama run llama3 即可启动交互式对话,无需额外配置环境变量。 首次运行会自动下载模型权重至本地缓存,后续调用速度显著提升。用户可通过 ollama list 查看已安装模型,使用 ollama serve 启动兼容 OpenAI 的 REST API 服务。
Ollama 适合用于 本地原型开发验证、内网私有 LLM 服务、教学与模型对比。其综合评分为 4.5/5 分,具备开箱即用、社区活跃、架构设计轻量等优势,能够无缝集成到现有的 AI 工作流中。
综合评分 4.5/5 反映其易用性优势:内置 Llama 3、Qwen 等主流模型,Apple Silicon 与 NVIDIA CUDA 加速开箱可用。API 兼容 OpenAI 生态,便于现有工具链迁移。 局限性在于量化选项较少,默认仅提供少量 GGUF 版本。高级用户对 KV 缓存、批处理等底层参数的控制能力有限,难以满足生产环境对吞吐量的极致要求。
C++ 实现的高效 LLM 推理引擎