官网预览
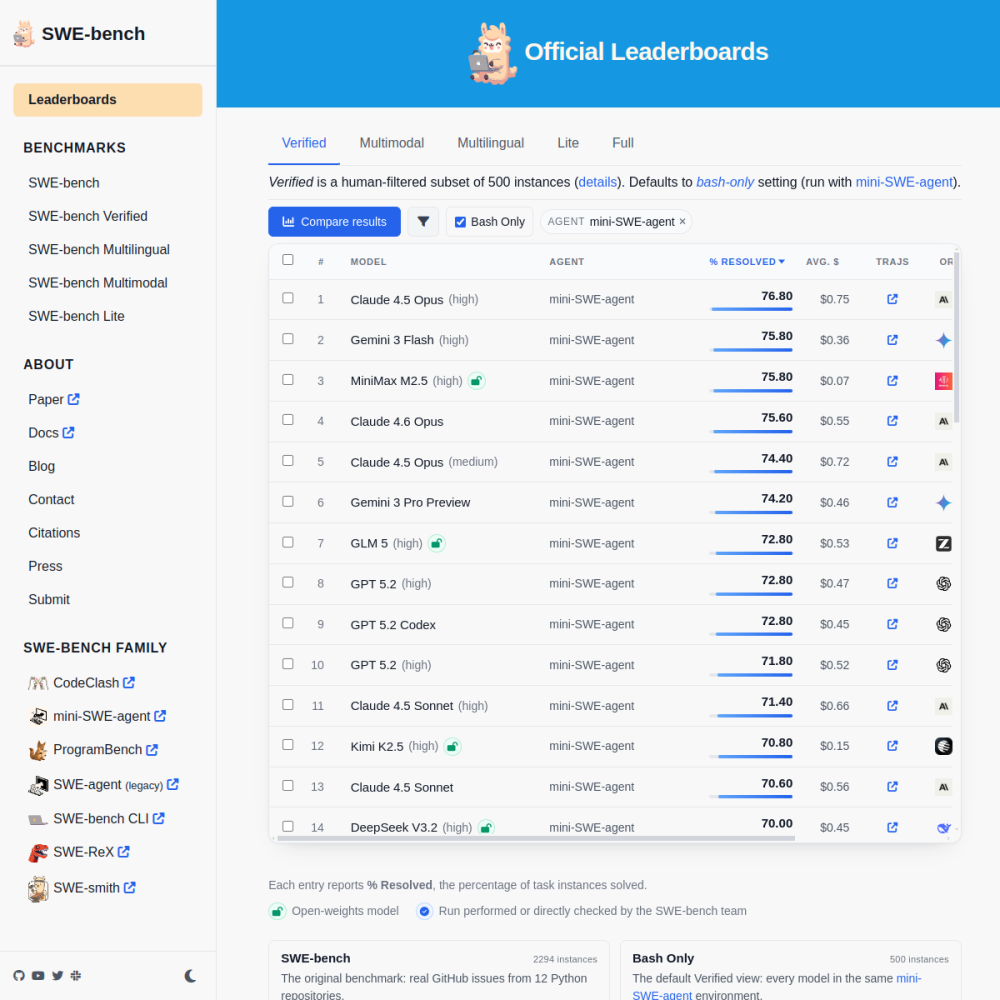
工具详解
SWE-bench是一个面向软件工程Agent的评测基准,核心思路是从真实GitHub仓库中提取已解决的Issue,要求模型生成补丁来修复问题,并以测试用例是否通过作为评判标准。
与传统的代码生成基准不同,SWE-bench强调端到端的工程能力——模型需要理解问题描述、定位相关代码、编写修复方案并通过验证。这使得它成为衡量大模型在真实软件工程任务中表现的重要参考。
SWE-bench由普林斯顿大学等机构的研究者提出,收录了来自多个开源Python项目的真实Issue。每个任务包含问题描述、相关代码库快照以及一组用于验证修复结果的测试用例。
评测流程是:模型接收Issue描述和代码上下文,生成一个补丁,系统自动应用补丁并运行测试。测试全部通过则视为该Issue被成功解决。
官网 swebench.com 提供基准数据集、评测脚本和排行榜,方便研究者复现和对比不同模型的表现。
SWE-bench的核心特点在于真实性——所有任务均来自实际开源项目,而非人工构造的练习题。模型面对的是真实的代码复杂度、模糊的问题描述和多样的修复路径。
评测维度覆盖代码理解、缺陷定位、补丁生成和测试验证等环节,能够较为全面地反映Agent在软件工程任务中的综合能力。
数据集持续更新,保持与开源社区的实际需求同步,避免基准过时导致评测结果失真。
SWE-bench主要面向以下几类用户:大模型研究者用它对比不同架构和训练策略在工程任务上的效果;AI产品团队用它评估候选模型是否适合集成到开发工作流中;学术写作者引用其结果作为实验依据。
对于个人开发者而言,了解SWE-bench的评测逻辑也有助于判断各类AI编程助手的实际能力边界,避免被营销话术误导。
最常见的场景是模型选型——团队在引入AI编程助手前,通过SWE-bench排行榜了解各模型在真实Issue修复上的成功率,作为决策参考。
另一个场景是研究实验:研究者将新提出的方法在SWE-bench上跑分,与已有基线对比,验证改进的有效性。
部分团队还将SWE-bench的评测流程改造为内部工具,用于持续监控模型版本更新后的工程能力变化。
访问官网 swebench.com 可获取数据集和评测脚本。一般流程是:下载对应版本的数据集,准备待评测模型的推理接口,运行评测脚本,最后查看结果报告。
需要注意的是,SWE-bench的评测结果受模型版本、推理参数和计算资源影响,不同环境下的分数可能存在差异。此外,模型可能在训练数据中已接触过部分Issue,解读分数时应结合具体背景。
核心指标是Issue解决率,即模型成功修复的Issue占总任务数的比例。分数越高说明模型在真实工程任务中的表现越好。但需注意,不同数据集版本和评测配置会影响可比性,跨版本对比时应谨慎。
SWE-bench最初以Python项目为主,后续版本逐步扩展了其他语言的支持。具体覆盖范围可查阅官网数据集说明,选择与自身技术栈匹配的版本进行评测。
如果你正在评估AI编程工具的实际能力,SWE-bench排行榜提供了有价值的参考。它比简单的代码补全测试更接近真实开发场景,能帮助判断工具在复杂任务上的可靠性。
AI模型对战评估平台